Machine Learning virou sinônimo de "inteligência", "futuro" e um monte de palavra bonita que não explica nada. No fundo, a ideia é bem mais simples do que o hype sugere — e saber quando NÃO usar ML vale tanto quanto saber usar.
O que Machine Learning é (e o que não é)
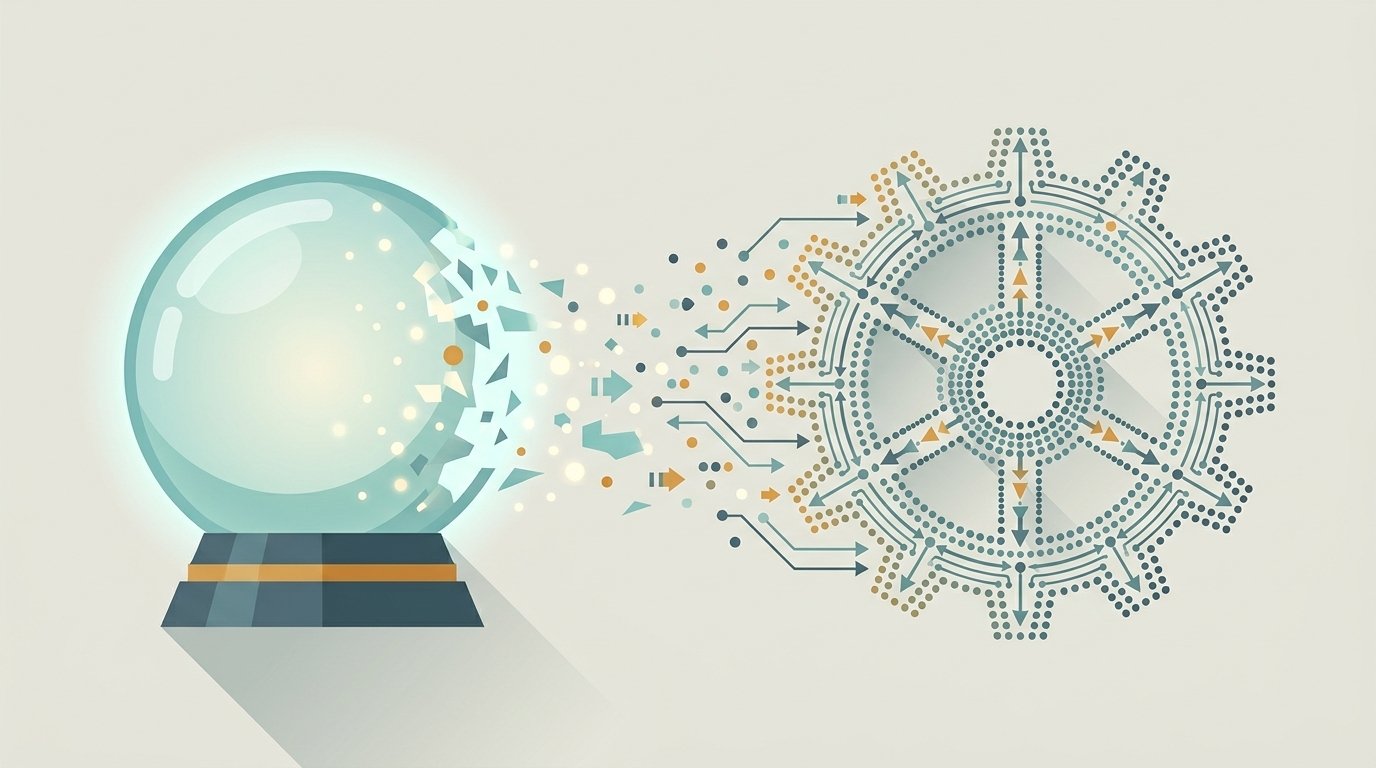
Em código tradicional, você escreve as regras: if idade > 18 então maior_de_idade. Em Machine Learning, você faz o contrário — dá exemplos ao computador e deixa ele descobrir as regras sozinho.
É isso. Nada de consciência, nada de mágica. Um modelo de ML é basicamente uma função que recebe dados de entrada e cospe uma previsão, ajustada a partir de milhares de exemplos que você mostrou antes. Se os exemplos forem ruins, a previsão será ruim. Lixo entra, lixo sai — só que agora com uma camada de matemática por cima.
Supervisionado vs. não supervisionado
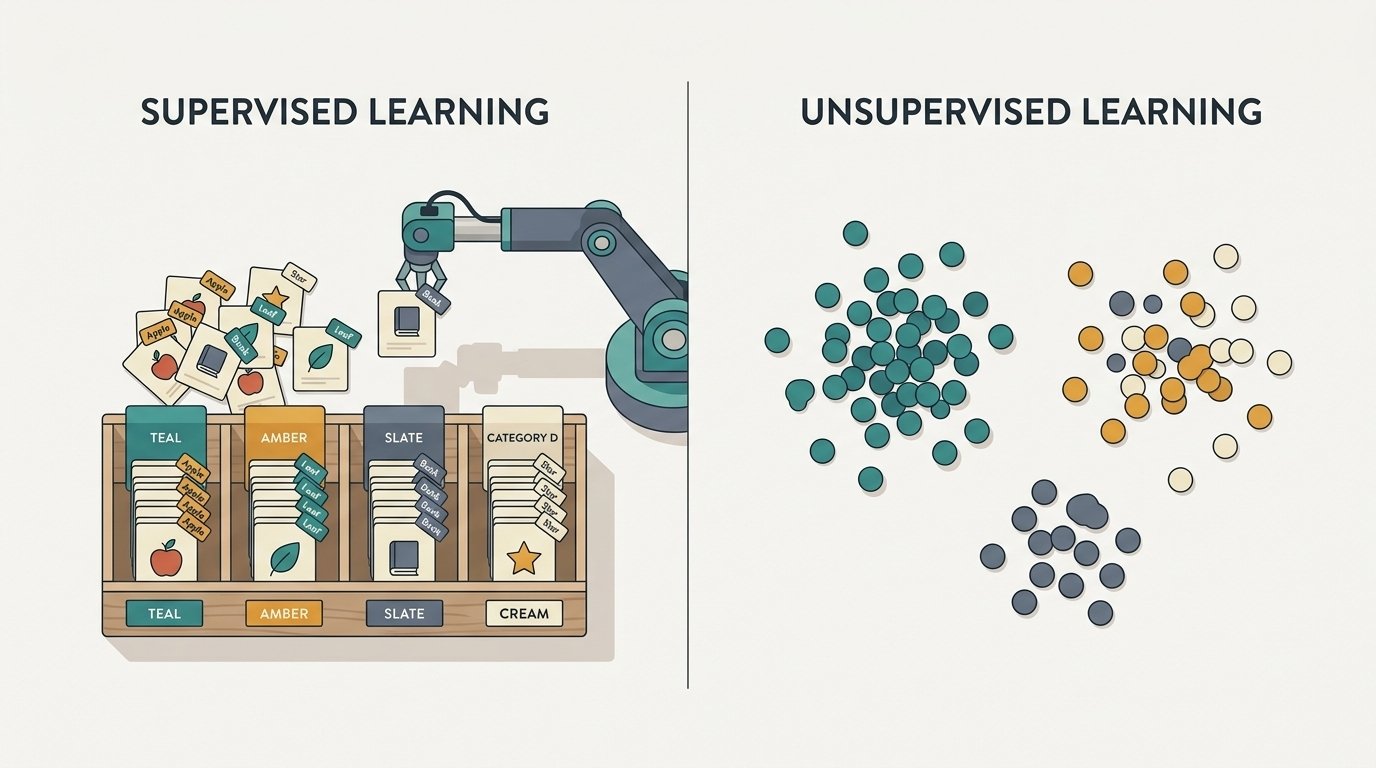
A divisão mais básica de ML depende de uma pergunta: você tem as respostas certas ou não?
No aprendizado supervisionado, você tem. Cada exemplo vem com um rótulo: esta foto é de um gato, este e-mail é spam, esta casa foi vendida por R$ 400 mil. O modelo aprende a mapear entrada para resposta. É de longe o tipo mais usado no dia a dia.
No aprendizado não supervisionado, você não tem rótulos. Você joga os dados e pede para o algoritmo achar padrões — agrupar clientes parecidos, por exemplo, sem dizer antes quais grupos existem. Útil para explorar, mas mais difícil de avaliar, porque não há gabarito para conferir.
Features e labels: o vocabulário que importa
Dois termos aparecem o tempo todo. Features são as entradas, as características que você usa para prever algo: tamanho da casa, bairro, número de quartos. Label é a resposta que você quer prever: o preço.
A parte que ninguém conta: escolher e preparar boas features costuma dar mais resultado do que trocar de algoritmo. Um modelo simples com features bem pensadas ganha de um modelo sofisticado alimentado com lixo. A maior parte do trabalho real de ML é justamente essa — cuidar dos dados, não brincar com redes neurais.
Treino, validação e teste: por que dividir os dados
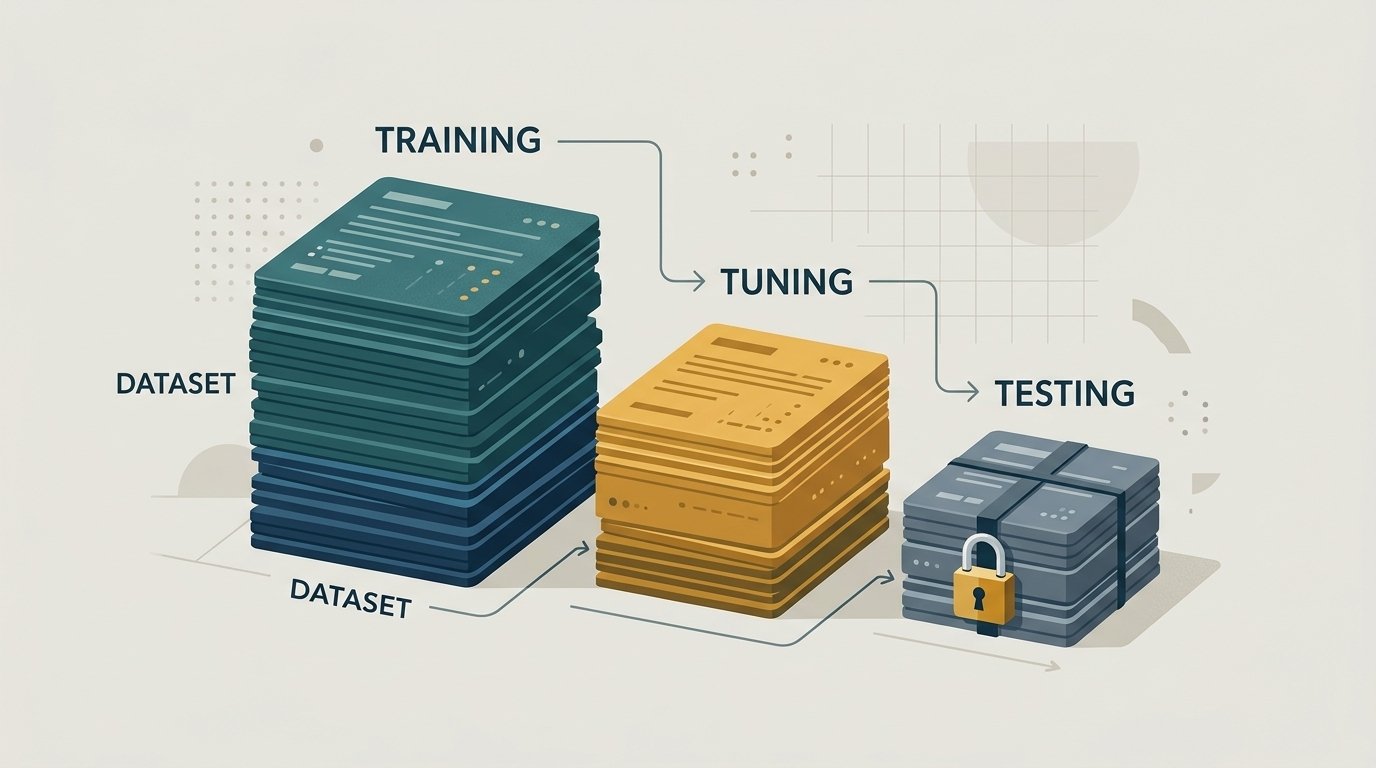
Se você treina e testa o modelo nos mesmos dados, ele parece um gênio — e te engana. Decorar não é aprender.
Por isso os dados são divididos em três partes. O conjunto de treino é onde o modelo aprende. O de validação serve para ajustar as configurações e comparar opções sem contaminar o resultado final. E o de teste fica trancado até o fim, tocado uma única vez, para medir como o modelo se sai com dados que nunca viu. É o mais perto que você chega de simular o mundo real antes de colocar em produção.
Overfitting: quando o modelo decora em vez de aprender
Overfitting é o pesadelo clássico. O modelo aprende os exemplos de treino tão bem, incluindo os ruídos e as coincidências, que vai maravilhosamente bem no treino e mal em qualquer dado novo.
Pensa no estudante que decora a lista de exercícios em vez de entender a matéria: tira dez na lista repetida e trava na prova diferente. A cura é aquele conjunto de teste separado, que denuncia o problema, e modelos mais simples, que têm menos espaço para decorar. Na dúvida entre um modelo simples e um complexo com desempenho parecido, fique com o simples.
Quando NÃO usar Machine Learning
Essa é a parte que o hype esconde. ML não é a resposta padrão — muitas vezes é a mais cara e frágil.
Se as regras do problema são conhecidas e estáveis, escreva as regras. Um if de três linhas é mais rápido, mais barato e infinitamente mais fácil de depurar do que um modelo que ninguém entende. ML também não salva quando você tem poucos dados, quando os dados são de baixa qualidade, ou quando você precisa explicar cada decisão com clareza jurídica.
A pergunta honesta antes de qualquer projeto de ML é: dá para resolver isso sem ML? Se der, resolva sem. Guarde o Machine Learning para os problemas onde as regras são complexas demais ou mudam demais para você escrever à mão — reconhecer imagem, prever demanda, filtrar spam que se reinventa toda semana. Aí sim ele brilha.
Machine Learning é uma ferramenta poderosa e, como toda ferramenta poderosa, perigosa nas mãos de quem a usa por moda. Aprenda os conceitos, respeite os dados e, principalmente, tenha a coragem de escolher o if/else quando ele for a resposta certa.