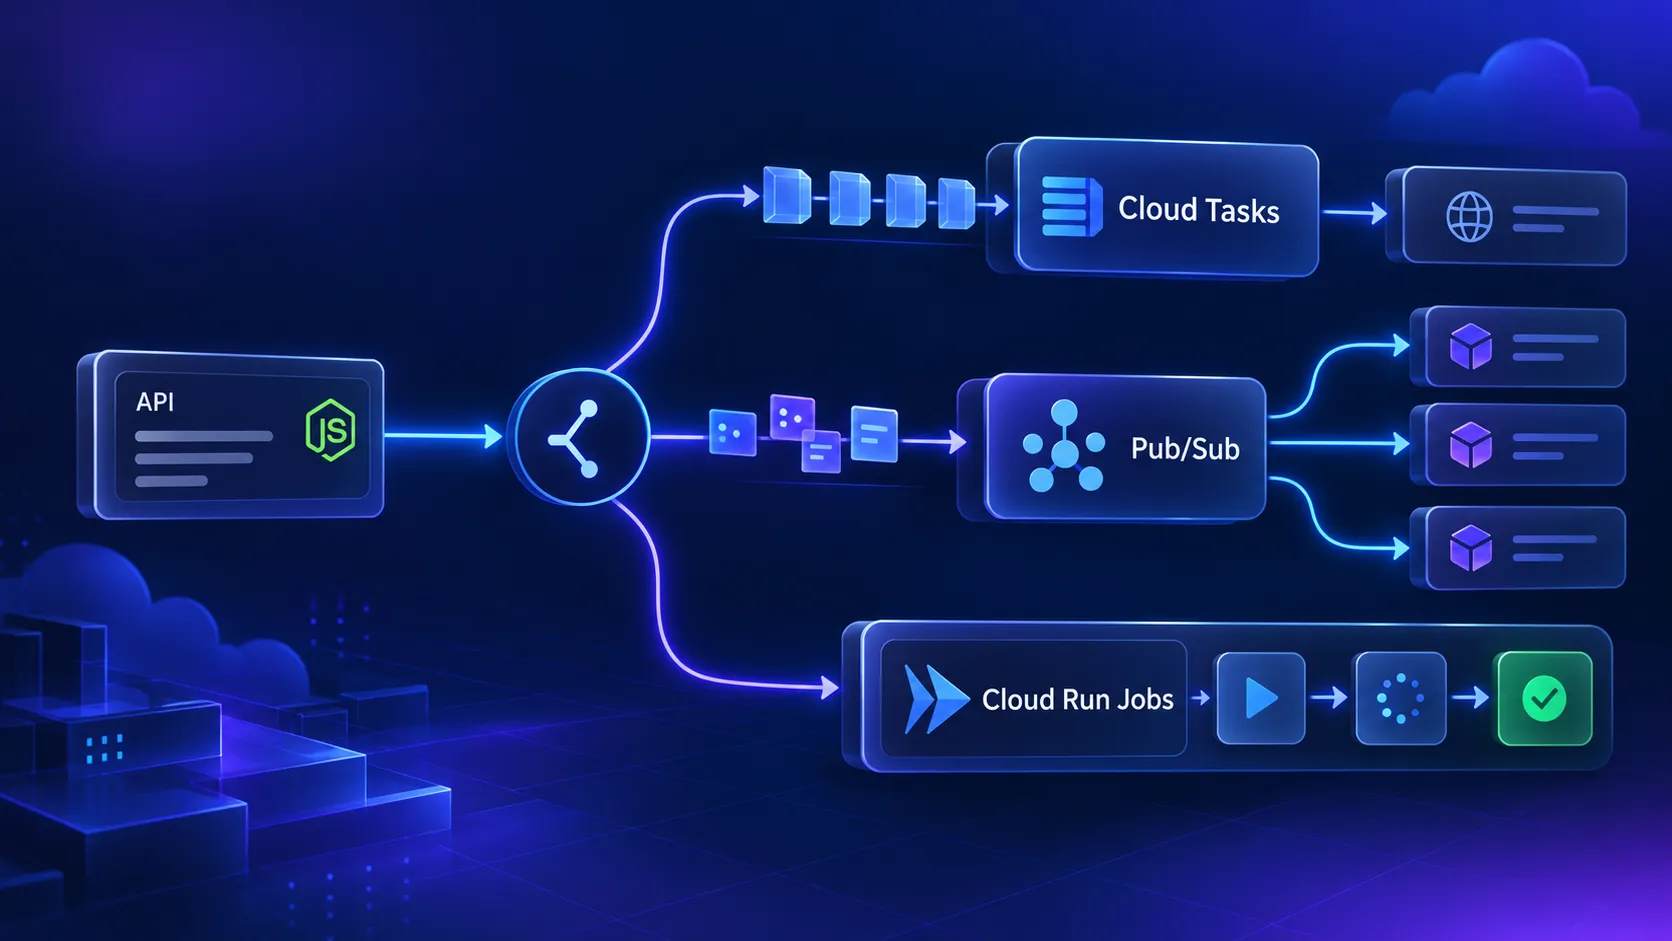
En sistemas distribuidos, es común resumir cualquier trabajo fuera del flujo principal como “asíncrono”. A partir de ahí, la conversación suele avanzar rápidamente hacia “pongámoslo en una cola”, “publiquemos en un tópico” o “ejecutemos un job”.
Sin embargo, el procesamiento asíncrono en GCP no empieza por la herramienta. Empieza por el contrato.
Antes de elegir entre Cloud Tasks, Pub/Sub y Cloud Run Jobs, conviene responder: ¿quién inicia el trabajo? ¿Quién necesita reaccionar? ¿El destino es conocido? ¿La ejecución debe terminar como una unidad finita? Y, principalmente: ¿qué ocurre cuando algo falla a mitad del proceso?
Cloud Tasks, Pub/Sub y Cloud Run Jobs resuelven problemas parecidos en apariencia, pero muy diferentes en cuanto al contrato de negocio. Cuando esa diferencia queda clara, la arquitectura tiende a ser más sencilla de operar, más fácil de observar y menos dependiente de la esperanza de que “la cola lo resolverá”.
TL;DR
- Usa Cloud Tasks cuando una aplicación necesita solicitar una acción específica a un destino conocido, normalmente un handler HTTP.
- Usa Pub/Sub cuando el sistema necesita comunicar que algo ocurrió y permitir que consumidores independientes reaccionen.
- Usa Cloud Run Jobs cuando el trabajo es finito, batch u operativo, y debe ejecutarse hasta completarse o fallar.
- Un reintento no significa ejecución exactamente una vez. Los handlers, consumidores y jobs deben manejar duplicados, efectos parciales y reprocesamiento.
- En flujos reales, los tres servicios pueden coexistir: una tarea inicia una acción, un evento comunica el hecho confirmado y un job reconcilia las divergencias posteriormente.
El procesamiento asíncrono en GCP comienza por el contrato, no por la herramienta
La primera pregunta no debería ser “¿qué servicio de GCP usamos?”. Debería ser: ¿cuál es la intención de esta operación?
En la práctica, existen al menos tres intenciones arquitectónicas muy diferentes:
-
Ordenar una acción a un destino conocido.
Ejemplo: “solicita el pago de esta factura en este endpoint”. -
Publicar un hecho para interesados independientes.
Ejemplo: “el pago de esta factura fue confirmado”. -
Ejecutar un trabajo finito que debe llegar a su fin.
Ejemplo: “reconcilia todos los pagos de ayer con el proveedor externo”.
Estas tres intenciones pueden ser asíncronas, pero no necesariamente requieren el mismo mecanismo.
“Asíncrono” solo significa que el trabajo no tiene que terminar dentro del flujo inmediato de quien inició la operación. Eso no indica, por sí solo, si necesitas una cola de tareas HTTP, un bus de eventos o una ejecución batch controlada.
Un error común es elegir el servicio porque ya existe en el proyecto. “Ya tenemos Pub/Sub, así que publiquemos un mensaje”. “Ya tenemos Cloud Tasks, así que creemos una tarea”. Esta decisión parece pragmática al principio, pero puede ocultar una duda importante: ¿qué contrato existe entre quien produce y quien consume este trabajo?
Si ese contrato no está explícito, la herramienta se convierte en un detalle. Y un detalle no sostiene la confiabilidad.
Cloud Tasks: cuando una aplicación necesita solicitar una acción específica
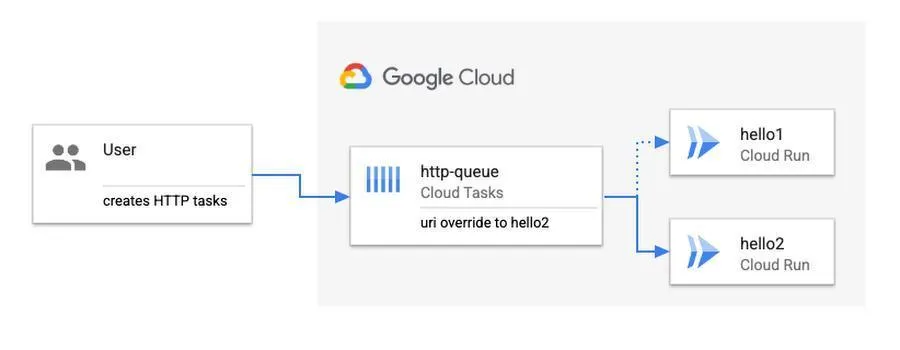
Cloud Tasks es una buena opción cuando una aplicación necesita crear una tarea para entregarla a un handler HTTP conocido, con control de programación, tasa, concurrencia y reintentos.
El modelo mental es: “sé qué acción debe ocurrir y quién debe ejecutarla, pero no quiero hacerlo dentro de la respuesta de la solicitud original”.
Algunos escenarios típicos:
- Iniciar un cobro después de confirmar un pedido.
- Solicitar el pago de una factura ya creada.
- Enviar una notificación a un usuario específico.
- Llamar a una integración externa sin bloquear la respuesta de la API.
- Ejecutar una acción en un momento futuro.
La relación con Cloud Run suele ser directa: Cloud Tasks envía una solicitud HTTP a un endpoint expuesto por un servicio de Cloud Run. El servicio procesa la solicitud y responde con éxito o error. La respuesta importa porque informa a la infraestructura si esa entrega puede considerarse completada o si debe intentarse nuevamente.
Un flujo simplificado podría ser:
- La API recibe la confirmación de un pedido.
- La API persiste el pedido y el estado esencial de la intención de cobro.
- La API registra de forma duradera que existe una acción de cobro por ejecutar.
- Se crea la tarea para llamar al endpoint responsable de iniciar el cobro.
- Solo entonces la API responde al cliente con un estado consistente.
El punto importante está entre los pasos 2 y 4. No basta con “guardar en la base de datos y después intentar ponerlo en la cola”, como si nada pudiera fallar en medio. Si la aplicación persiste el pedido, falla antes de crear la tarea y aun así responde con éxito, puede existir trabajo pendiente sin trazabilidad operativa.
Una forma común de manejar esto es persistir una intención de procesamiento, como un intento de pago pendiente, y contar con algún mecanismo confiable para crear o recrear la tarea si falla la llamada a Cloud Tasks. Según el contexto, esto puede ser un patrón outbox, una rutina de reconciliación o una transición de estado que haga visibles las pendientes para su reprocesamiento.
Un ejemplo en Node.js, sin entrar en los detalles del SDK, podría seguir esta idea:
js app.post("/orders/:id/confirm", async (req, res) => { const orderId = req.params.id;
const result = await db.transaction(async (tx) => { const order = await tx.orders.confirm(orderId);
const paymentAttempt = await tx.paymentAttempts.create({
  orderId,
  status: "pending",
  provider: "external-provider"
});

await tx.processingIntents.create({
  type: "start_payment",
  referenceId: paymentAttempt.id,
  status: "pending_task_creation"
});

return { order, paymentAttempt };
});
await createCloudTask({ url: "https://payment-service.example/internal/start-payment", payload: { order_id: result.order.id, payment_attempt_id: result.paymentAttempt.id } });
await db.processingIntents.markTaskCreated({ referenceId: result.paymentAttempt.id });
res.status(202).json({ order_id: result.order.id, payment_attempt_id: result.paymentAttempt.id, status: "payment_scheduled" }); });
Este ejemplo todavía está simplificado. En producción, tendrías que pensar qué ocurre si createCloudTask funciona y la actualización markTaskCreated falla, o si la creación de la tarea devuelve un error después de que la tarea ya fue creada. El diseño exacto depende del sistema, pero la regla general permanece: la intención de procesamiento debe ser duradera y trazable.
Cloud Tasks ayuda bastante cuando necesitas:
- Programación: entregar la tarea ahora o en un momento futuro.
- Límite de tasa: controlar el ritmo de las llamadas para proteger un servicio interno o externo.
- Concurrencia: evitar que muchas tareas se procesen al mismo tiempo.
- Reintentos: volver a intentar cuando el handler falla.
- Plazo de ejecución de la solicitud: delimitar cuánto tiempo tiene el handler para responder.
El trade-off es que el productor conoce el destino de la acción. Esto simplifica el flujo, facilita rastrear “quién ordenó hacer qué” y combina bien con comandos explícitos. Por otro lado, crea un acoplamiento directo entre quien pone la tarea en la cola y quien la ejecuta.
La principal precaución: no trates el handler como si fuera a llamarse una sola vez. Puede recibir entregas repetidas. Puede fallar después de haber ejecutado parte del trabajo. Puede llamar a un proveedor externo y perder la respuesta. Si la operación tiene un efecto de negocio relevante, el handler debe ser idempotente y debe saber cómo retomar un intento incompleto.
Pub/Sub: cuando el sistema necesita comunicar que algo ocurrió
Pub/Sub funciona mejor cuando el sistema necesita publicar un evento: ocurrió algo relevante y distintas partes de la arquitectura pueden querer reaccionar.
La diferencia entre comando y evento es sutil, pero importante:
- Comando: “envía este cobro a este destino”.
- Evento: “el cobro fue confirmado”.
En el comando, alguien está solicitando una acción específica. En el evento, alguien está anunciando un hecho ocurrido.
Pub/Sub es útil cuando varios consumidores pueden reaccionar de forma independiente al mismo hecho de negocio:
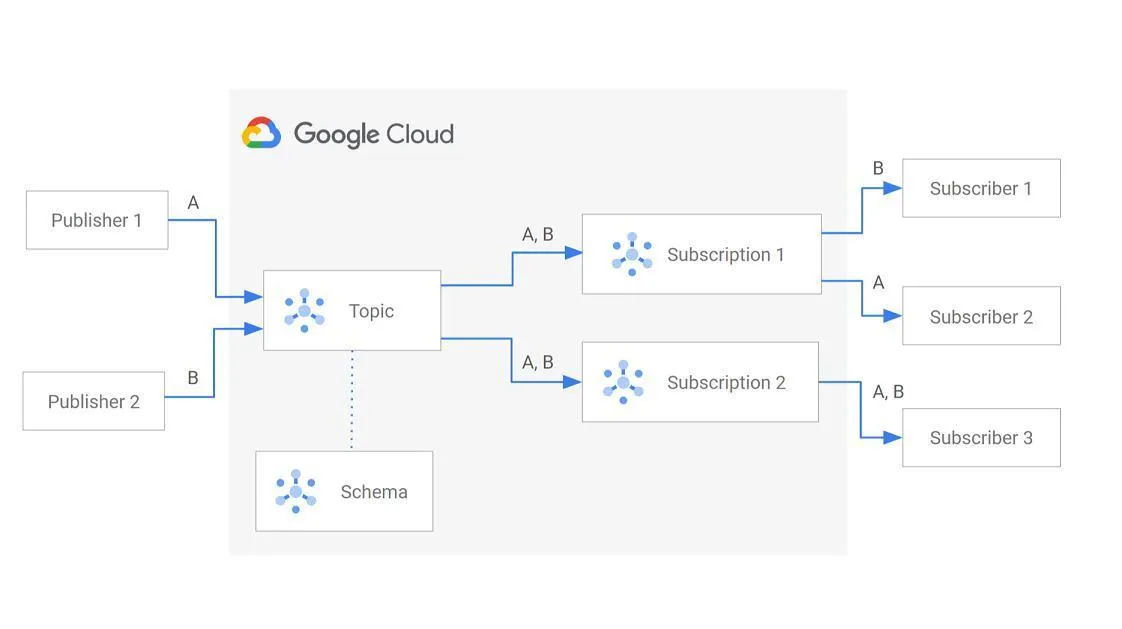
- La creación de un pedido genera notificaciones, actualiza analytics y sincroniza el CRM.
- Un pago confirmado actualiza el saldo, emite un documento fiscal y alimenta flujos de comunicación.
- Un cambio en los datos de un cliente activa integraciones con sistemas independientes.
Imagina un servicio de pedidos que publica OrderCreated. Una suscripción procesa el inventario. Otra envía una campaña de bienvenida. Una tercera alimenta un sistema analítico.
El productor no necesita conocer a esos consumidores. Publica el hecho de negocio y continúa su flujo. Cada suscripción tiene su propio ciclo de procesamiento, sus propios fallos y su propia evolución.
Esto ofrece una ventaja clara: se pueden agregar nuevos consumidores sin modificar el productor. Además, el fallo de un consumidor no tiene por qué impedir que los demás reciban el evento.
Pero esta libertad tiene un coste. Pub/Sub reduce el acoplamiento entre productores y consumidores, pero exige más disciplina en:
- los contratos de los mensajes;
- el versionado de los eventos;
- la trazabilidad entre servicios;
- la observabilidad de los flujos distribuidos;
- el tratamiento de duplicados;
- la semántica clara sobre lo que realmente significa el evento.
Un error común es publicar mensajes que, en la práctica, son instrucciones internas para un único servicio. Por ejemplo: SendPaymentToProviderCommand publicado en un tópico consumido por un único worker conocido. Puede funcionar, pero quizá hayas transformado una acción dirigida en un evento artificial, agregando complejidad sin obtener una independencia real.
La pregunta útil aquí es: ¿el productor realmente necesita conocer quién consumirá esta información?
Si la respuesta es “no, varios interesados pueden reaccionar a este hecho”, Pub/Sub suele tener sentido. Si la respuesta es “sí, necesito que ese servicio ejecute esta acción específica”, quizá Cloud Tasks represente mejor el contrato.
Cloud Run Jobs: cuando el trabajo es finito y no cabe en el ciclo de una solicitud
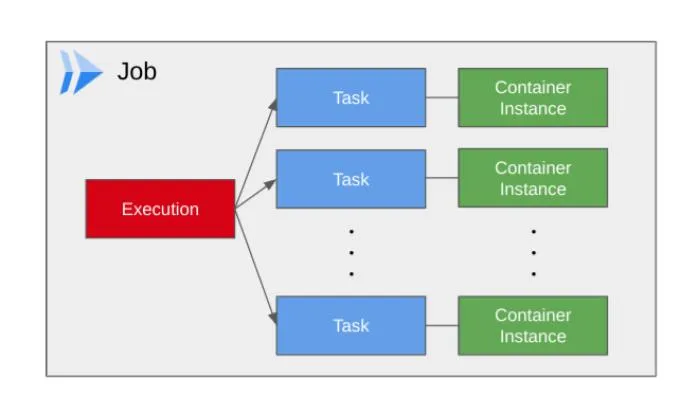
Cloud Run Jobs resuelve otro tipo de problema. En lugar de mantener un servicio HTTP disponible para responder solicitudes, ejecutas un container hasta que termine.
El modelo mental es: “existe un trabajo finito, con principio y fin, que debe ejecutarse hasta completarse o fallar”.
Algunos ejemplos:
- Reprocesar datos históricos.
- Generar informes o archivos consolidados.
- Importar una base de datos recibida de un partner.
- Ejecutar la reconciliación de cobros.
- Ejecutar migraciones operativas o tareas batch controladas.
La diferencia con un servicio de Cloud Run está en el ciclo de vida:
- Un service responde solicitudes.
- Un job inicia una ejecución y termina cuando el trabajo se completa o falla.
Considera una rutina de reconciliación de pagos. El sistema tiene registros internos de cobros, pero también necesita comparar esos registros con el proveedor externo. Un job puede buscar los pagos confirmados en el proveedor, compararlos con la base interna y generar una lista de divergencias para su tratamiento.
Esto no es exactamente un evento individual. Tampoco es una llamada HTTP aplazada a un handler específico. Es un proceso finito de exploración, comparación y producción de un resultado.
Cloud Run Jobs también permite pensar en paralelismo. Puedes dividir una carga en varias tareas del job cuando:
- el volumen es grande;
- los elementos son relativamente independientes;
- existe una forma clara de particionar el trabajo;
- la rutina admite una ejecución parcial repetida.
Por otro lado, una ejecución secuencial puede ser mejor cuando:
- la simplicidad operativa importa más que la velocidad;
- existe dependencia entre las etapas;
- el volumen está controlado;
- la consistencia del proceso es más importante que el paralelismo.
El trade-off es que los jobs son excelentes para el procesamiento finito y controlado, pero no sustituyen un mecanismo de entrega de eventos ni una cola de acciones HTTP.
Una señal de alerta: usar un job para cada evento individual de alto volumen. En ese caso, quizá estés transformando una necesidad de consumo continuo en muchas ejecuciones aisladas, aumentando el coste operativo y dificultando la observabilidad.
Comparación de las opciones: intención, destino, consumidores y ciclo de ejecución
La tabla siguiente no es una regla mecánica. Es un punto de partida para discutir la intención, el contrato y los fallos.
| Criterio | Cloud Tasks | Pub/Sub | Cloud Run Jobs |
|---|---|---|---|
| Intención principal | Solicitar una acción | Comunicar un evento | Completar un trabajo finito |
| Destino | Conocido por el productor | Suscripciones independientes | Ejecución de un container |
| Consumidores | Normalmente un handler por tarea | Uno o varios consumidores | Un proceso o conjunto de tareas del job |
| Control de programación | Fuerte | Depende del consumidor o de la arquitectura | Puede activarse bajo demanda o mediante otro mecanismo |
| Reintentos | Enfocados en la entrega de la tarea | Enfocados en el consumo por suscripción | Enfocados en la ejecución del trabajo |
| Entrega y duplicados | Al menos una vez; el handler debe ser idempotente | Al menos una vez por defecto; el consumidor debe tratar los duplicados | Reintentos por tarea del job; la rutina debe admitir una ejecución segura repetida |
| Más adecuado para | Llamadas HTTP confiables y aplazadas | Fan-out e integración desacoplada | Batch, reprocesamiento y rutinas finitas |
Una forma sencilla de orientar la decisión es responder estas preguntas:
- ¿Estoy solicitando una acción o anunciando un hecho?
- ¿El productor conoce y debe controlar el destino?
- ¿Uno o varios consumidores necesitan reaccionar?
- ¿El trabajo cabe en el tiempo de una solicitud HTTP?
- ¿Necesito programar, limitar el ritmo o controlar la concurrencia?
- Si ocurre un fallo, ¿qué significa reprocesar?
La última pregunta suele revelar más de lo que parece. Si reprocesar significa “volver a llamar al mismo endpoint con la misma intención”, Cloud Tasks puede encajar bien. Si significa “cada consumidor decide cómo manejar el mismo hecho”, Pub/Sub resulta más natural. Si significa “volver a ejecutar una rutina finita a partir de un estado conocido”, Cloud Run Jobs puede ser el camino.
El cuidado consiste en no elegir Pub/Sub únicamente porque parece más “desacoplado”. El desacoplamiento no es la ausencia de un contrato. A veces, el dominio necesita una acción explícita, trazable y dirigida.
Reintentos, reprocesamiento e idempotencia: el contrato debe sobrevivir a los fallos
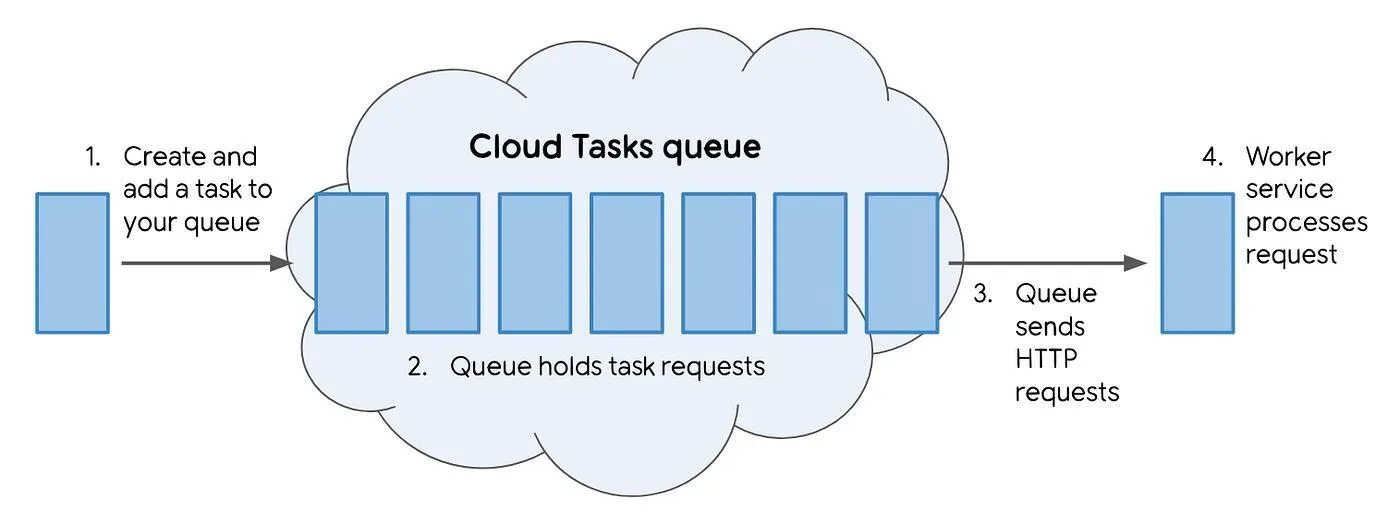
Un reintento no significa que el sistema vaya a ejecutar algo exactamente una vez. En general, significa que intentará entregar o ejecutar de nuevo cuando algo parezca haber fallado.
Pero ¿qué ocurre si la llamada falla a mitad de camino?
Imagina un handler que inicia un cobro en un proveedor externo. Puede:
- llamar al proveedor y recibir una respuesta exitosa;
- llamar al proveedor y recibir un error;
- llamar al proveedor, que procesa la operación, pero perder la respuesta;
- persistir el resultado localmente y fallar antes de responder a la infraestructura;
- responder con éxito demasiado pronto y perder después un fallo relevante.
Por eso, la idempotencia no es solo un detalle técnico. Es una propiedad de la operación de negocio.
Algunos ejemplos:
- Repetir el mismo cobro no puede generar un segundo cobro indebido.
- Reenviar la misma notificación puede requerir una clave de deduplicación o un identificador de entrega.
- Reprocesar un evento no debe corromper el estado agregado.
- Ejecutar nuevamente una reconciliación no debería duplicar divergencias ya registradas.
Un identificador como payment_attempt_id puede ayudar bastante, pero no es una solución mágica por sí solo. Debe estar asociado a una regla persistida en la base de datos, como una restricción de unicidad, una máquina de estados o una tabla de intentos con transiciones bien definidas.
Cuando sea posible, este mismo identificador también debería utilizarse como clave de idempotencia en la integración con el proveedor externo. Así, varios intentos de la misma operación tienen más posibilidades de reconocerse como la misma intención y no como nuevos cobros independientes.
Un flujo más seguro podría seguir esta idea:
- Crear
payment_attempt_iden la base de datos con el estadopending. - Enviar la solicitud al proveedor usando ese identificador como clave de idempotencia.
- Persistir el resultado recibido o un estado intermedio suficiente para reconciliar la operación.
- Responder con éxito a la infraestructura solo cuando el efecto necesario esté confirmado o cuando exista suficiente estado persistido para retomar y reconciliar la operación de forma segura.
Este último punto es importante. El handler no debe devolver éxito simplemente porque “recibió el mensaje”. Debe devolver éxito cuando se haya cumplido la parte esencial del contrato o cuando el sistema tenga suficiente estado para no perder la operación.
También conviene separar tres decisiones:
-
¿Cuándo volver a intentarlo?
Los errores transitorios, los timeouts y la indisponibilidad temporal pueden justificar reintentos. -
¿Cuándo detenerse y derivar el caso para análisis?
Los errores de validación, las inconsistencias de dominio o las respuestas inesperadas pueden requerir intervención o un tratamiento específico. -
¿Cómo reprocesar después de corregir un fallo sistémico?
Si un bug afectó a varios elementos, la recuperación quizá necesite un job y no reintentos infinitos elemento por elemento.
Cuanto más automático sea el reintento, mayor será la responsabilidad de proteger los servicios externos frente a duplicados, sobrecarga y efectos irreversibles.
También ayuda incluir en los payloads identificadores de negocio y metadatos suficientes para el diagnóstico: order_id, payment_attempt_id, event_id, correlation_id, la versión del contrato y el origen del mensaje. Los logs son importantes, pero no deberían ser el único lugar donde exista la operación.
Arquitecturas combinadas: los tres servicios pueden coexistir
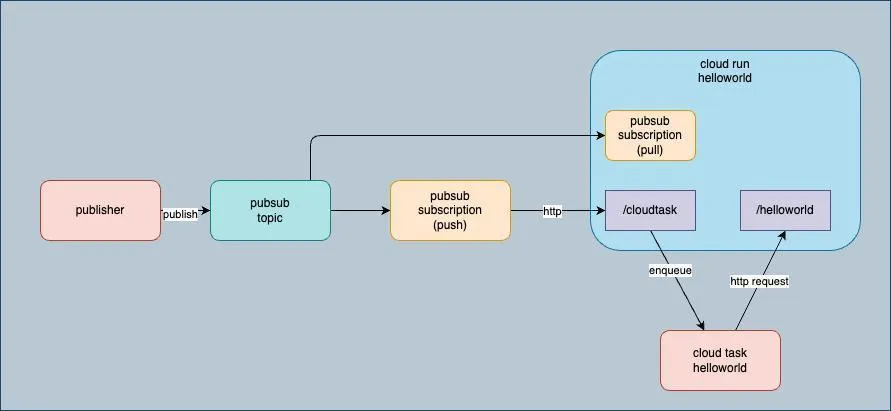
Cloud Tasks, Pub/Sub y Cloud Run Jobs no tienen por qué competir entre sí. En muchos sistemas aparecen juntos porque resuelven contratos diferentes dentro del mismo flujo.
Un flujo de cobro podría ser el siguiente:
- La API registra el pedido y crea una tarea en Cloud Tasks para iniciar el cobro.
- El handler procesa el intento de pago y confirma el resultado.
- Después de la confirmación, el servicio publica un evento en Pub/Sub.
- Consumidores independientes reaccionan al pago confirmado.
- Una rutina periódica de reconciliación se ejecuta como Cloud Run Job para identificar divergencias con el proveedor de pagos.
En Mermaid, el flujo podría representarse así:
mermaid flowchart LR API[API de pedidos] --> DB[(Estado esencial persistido)] API --> CT[Cloud Tasks] CT --> PAY[Handler de pagos en Cloud Run] PAY --> EXT[Proveedor externo] PAY --> TOPIC[Pub/Sub: PaymentConfirmed] TOPIC --> BAL[Actualización de saldo] TOPIC --> DOC[Documento fiscal] TOPIC --> COM[Comunicación con el cliente] JOB[Cloud Run Job de reconciliación] --> EXT JOB --> DB
Otro flujo común implica la integración con partners:
- Un evento de cambio en los datos de un cliente se publica en Pub/Sub.
- Un consumidor recibe el evento y crea tareas en Cloud Tasks para respetar el límite de solicitudes de una API de partner.
- Cada tarea llama a la integración externa al ritmo permitido.
- Los fallos acumulados se analizan y reprocesan mediante un Cloud Run Job.
En este diseño, Pub/Sub comunica el hecho, Cloud Tasks controla las llamadas dirigidas y Cloud Run Jobs ayuda en la recuperación operativa.
Un checklist sencillo:
- Acción para un destino conocido: considera Cloud Tasks.
- Hecho relevante para varios interesados: considera Pub/Sub.
- Proceso finito, batch o reprocesamiento controlado: considera Cloud Run Jobs.
- Más de una de estas necesidades en el mismo flujo: combina los servicios, manteniendo contratos claros.
Al final, la madurez de la arquitectura no está en “usar una cola”. Está en hacer explícitos el contrato de negocio, el comportamiento ante fallos, la estrategia de reprocesamiento y los límites de cada herramienta.
Para conversar sobre decisiones arquitectónicas y trade-offs con otros profesionales, sigue a la comunidad SCCB en Instagram.