Quería un flujo sencillo de describir y difícil de construir: un agente hace el papel de PO y escribe las issues conmigo, otro implementa, otro revisa, otro corrige y el proyecto sigue evolucionando. Con ese objetivo empecé a estructurar agentes en Claude Code para Hive, una app de marketing para pequeños negocios de servicios (manicura, pestañas y fotografía). La app móvil está hecha con React Native + Expo, y el backend es un .NET que ya existía y que decidimos reutilizar, sin reescribirlo.
Este artículo no trata sobre la promesa. Trata sobre lo que tuvo que existir para que esto funcionara de verdad: cómo se comunican los agentes (spoiler: no se comunican), dónde queda la memoria entre ellos, qué límites necesita cada rol y qué cambia cuando decides sacar al humano del medio.
Qué es, en la práctica, un agente en Claude Code
Un agente en Claude Code (el nombre oficial es subagent) es un archivo Markdown dentro de .claude/agents/. El encabezado indica quién es, cuándo usarlo y qué herramientas puede utilizar. El cuerpo es el manual del rol.
---
name: hive-developer
description: Implements one approved Hive feature on a dedicated branch and opens a PR. Use for Linear issues labeled role:implementation.
tools: Read, Write, Edit, Grep, Glob, Bash
---

# Role — Developer

Implement the approved feature on a dedicated branch and open a PR.

## Required inputs

The orchestrator gives you the Product and Architecture outputs. Do not silently
reinterpret their acceptance criteria. If they are missing or contradictory,
stop and report it — do not guess.
Dos propiedades marcan toda la diferencia:
- Contexto aislado. Cada agente empieza desde cero. No ve la conversación que tuviste antes ni lo que pensó otro agente. Esto es excelente para mantener el foco y terrible si esperabas que "recordara".
- Herramientas según el rol. El revisor de Hive solo tiene herramientas de lectura (
Read, Grep, Glob, Bash). No puede "hacer un pequeño arreglo" en el código, y es intencional: quien revisa no debería ser quien corrige.
Un detalle que me sorprendió: el subagente no conversa contigo durante la tarea. Recibe la solicitud, trabaja hasta el final y devuelve un resultado. Si la idea es tener un PO con quien discutir las issues en varias idas y vueltas, el lugar adecuado es un comando (slash command) que se ejecute en la sesión principal, no un subagente.
Los agentes en Claude Code no conversan: alguien tiene que orquestarlos
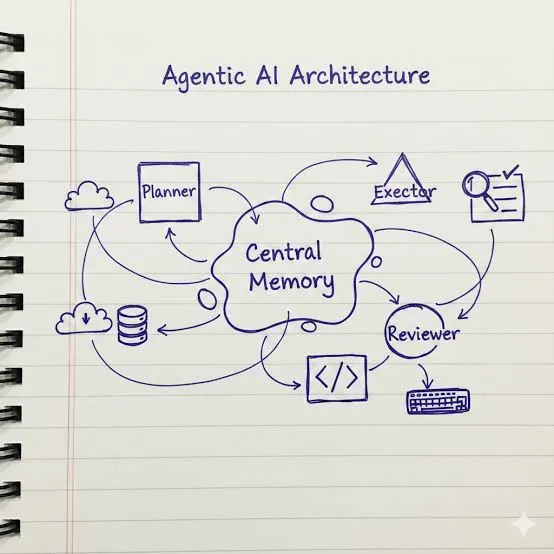
La imagen mental de "un agente le envía algo a otro" resulta seductora, pero no funciona así. Los agentes no intercambian mensajes entre sí. Quien coordina es la sesión principal, que desempeña el papel de orquestador: llama a un agente, recibe el resultado, decide el siguiente paso y transmite lo necesario.
En Hive, el orquestador incorporó dos comandos:
/hive-next: muestra qué issues ya pueden ejecutarse (sin bloqueos pendientes)./hive-issue HIVE-123: carga la issue, identifica el rol mediante la label y llama al agente correcto.
El enrutamiento es una tabla, sin magia:
| Label | Agente |
|---|---|
role:planning |
hive-planning |
role:product |
hive-product |
role:architecture |
hive-architect |
role:implementation |
hive-developer |
role:qa |
hive-qa |
role:review |
hive-reviewer |
role:fix |
hive-fix |
role:gate |
el propio orquestador evalúa |
Si la issue no tiene una label de rol o tiene dos, el orquestador no adivina: se detiene y pregunta. Esta es la primera regla que llevaría a cualquier proyecto: la ambigüedad en el enrutamiento es un bug, no un caso para resolver improvisando.
Linear como memoria compartida entre los agentes
Si ningún agente ve la sesión de otro, la información tiene que vivir en algún lugar fuera del chat. En Hive, ese lugar es Linear.
El modelo es directo: una issue = una etapa = una ejecución. Cada etapa termina publicando un comentario estructurado (STAGE_RESULT:, VALIDATION_RESULT:, REVIEW_RESULT:). La etapa siguiente depende de la anterior mediante la relación blocked_by y, antes de ejecutarse, el orquestador busca esos comentarios y se los entrega íntegramente al siguiente agente.
Esto resuelve tres problemas de una sola vez:
- Trazabilidad. Es posible abrir una funcionalidad y ver qué decidió el PO, qué propuso arquitectura, qué rechazó QA y por qué.
- Reanudación. Si la sesión se cae, no se pierde nada: el estado está en Linear, no en la memoria del modelo.
- Independencia. QA recibe los criterios de aceptación del PO, no la opinión del desarrollador sobre su propio código.
El trade-off apareció rápidamente: en el diseño original, cada funcionalidad se convertía en seis issues (producto, arquitectura, implementación, QA, revisión y gate). Es muy trazable y también genera mucho ruido. Volveremos a esto más adelante.
Los roles y por qué cada uno necesita límites
El equipo de Hive tiene siete roles. Lo que hace útil a cada uno no es lo que hace, sino lo que no puede hacer:
- Planificación propone el grafo de issues con sus dependencias. Quien crea las issues en Linear es el orquestador, y solo después de la aprobación.
- Producto define el comportamiento y los criterios de aceptación a partir del PRD. No escribe código.
- Arquitectura propone el plan técnico seguro e incremental más pequeño posible. No implementa.
- Desarrollo implementa en una branch dedicada y abre el PR. Si los criterios son contradictorios, se detiene y lo informa en lugar de "interpretarlos".
- QA tiene una misión deliberadamente incómoda: intentar demostrar que la implementación no cumple los criterios. Nunca corrige.
- Revisión realiza un code review sénior e independiente. Solo lee.
- Corrección se ocupa únicamente de los hallazgos validados por QA y revisión, en la branch existente.
Por encima de todos están las reglas de ingeniería del proyecto, en un archivo que los agentes consultan por sección: multitenancy obligatoria (el tenant se resuelve en el servidor, nunca viene del cliente), secretos fuera de Git y la prohibición de borrar o debilitar un test que falla solo para que el CI quede en verde.
Separar a quien implementa de quien valida es lo que transforma "varios prompts" en un equipo. Un agente que escribe y aprueba su propio código es solo un agente con más etapas.
Economía de contexto: el PRD de 2.700 líneas
El PRD de Hive tiene unas 2.700 líneas. En la automatización anterior, cada etapa leía el documento completo, y ese fue el mayor desperdicio de presupuesto de todo el proceso. Lo peor es que no ayudaba: el agente recibía un océano de contexto para responder una pregunta sobre una sección.
La solución fue sencilla y se convirtió en una regla del CLAUDE.md del proyecto:
- Existe un
prd-index.mdcon las secciones y sus rangos de líneas. - El agente lee el índice, encuentra la sección y lee solo ese fragmento.
sed -n '2602,2707p' docs/product/hive-product-prd-v6.md
La lección general: en un flujo multiagente, el contexto no es gratuito ni neutro. Cada agente debe recibir lo mínimo necesario para decidir bien, y el resto debe estar a una consulta de distancia.
Cuando cambia la documentación, el backlog se pudre
Este fue el problema más traicionero, porque no aparece como un error.
Las issues se escriben una vez y pueden quedar semanas detenidas. Mientras tanto, el producto cambia. En Hive, el alcance móvil se redujo a iOS primero, pero una issue de validación todavía exigía pruebas en Android. Si se ejecutaba, QA rechazaría una implementación correcta, el flujo abriría un ciclo de corrección y un agente perdería tiempo "arreglando" código que estaba bien.
Después llegó un cambio mayor: el plan de Hive Studio (grabación con teleprompter, envío por escena y edición automática de video) pasó a ser la fuente más actual del producto, y ninguna de las decenas de issues abiertas hablaba de él.
De ahí surgieron dos prácticas:
- Cuando cambia la documentación, audita el backlog antes de ejecutar cualquier etapa. Secciones renumeradas, alcance superado y criterios que contradicen decisiones más recientes son los sospechosos habituales.
- A veces lo mejor es empezar de nuevo el backlog. Revisar decenas de issues que ya nadie sabe hacia dónde llevan cuesta más que abrir un proyecto nuevo, basado en el documento actual, y conservar el anterior como historial.
Del humano en el loop al loop sin humanos: las decisiones que importan
El diseño original tenía a una persona presente: las dudas de producto iban a "Human Review" y solo una persona hacía el merge. Funciona, pero no escala para lo que yo quería: un flujo que continúe evolucionando la app por sí solo y me envíe un resumen de lo realizado.
Sacar al humano del loop no significa borrar una etapa. Significa sustituir el criterio humano por reglas explícitas. Estas son las que considero esenciales:
- Dónde ocurre el merge. Si nadie hace el merge, cada nueva funcionalidad se construye sin la anterior y el loop se atasca en una pila de PRs. La salida que tiene sentido es hacer merge automático en
developdespués de que QA y revisión aprueben, mientrasmastercontinúa siendo exclusivamente humano. La autonomía queda en una rama de integración, no en producción. - La duda de producto se convierte en una suposición registrada. El PO decide, escribe la decisión en la issue con una label de suposición y continúa. No apruebas antes, pero puedes auditar después.
- Un bloqueo no detiene la cola. Simulador no disponible, credencial ausente o servicio caído: la issue se marca como bloqueada, el motivo se registra una sola vez y el loop pasa a la siguiente. Reintentar un bloqueo externo que no ha cambiado es un desperdicio.
- Límite de ciclos de corrección. Si QA o revisión rechazan una issue más de dos veces, sale de la cola. Un ciclo infinito de correcciones es la forma más cara de descubrir que la especificación estaba equivocada.
- La cola se renueva. Cuando no hay nada listo para ejecutarse, el PO lee el plan actual y el código, y crea las siguientes pocas issues. Eso hace que el flujo "no se detenga" sin inventar funcionalidades futuras por su cuenta.
- Resumen para la persona responsable. Con cada entrega, un mensaje breve: qué se hizo, el PR y las suposiciones que adoptó el PO. Sales del camino crítico, pero no del control.
Y una regla operativa: nunca ejecutes dos automatizaciones contra el mismo backlog. Hive tenía una automatización anterior; con ambas activadas, competirían por el estado de las mismas issues.
Lo que aplicaría a cualquier proyecto
Si hoy tuviera que empezar un flujo con agentes en Claude Code para otro producto, empezaría por aquí:
- Agentes pequeños, con límites claros. El valor está en lo que cada rol no puede hacer.
- Handoff fuera del chat. Una herramienta de gestión (Linear, Jira, GitHub Issues) con comentarios estructurados es la memoria del equipo.
- Orquestador explícito. Enrutamiento basado en reglas y detención cuando exista ambigüedad.
- Contexto bajo demanda. Índices y lectura por fragmentos; nunca documentos completos de forma predeterminada.
- Backlog vivo. Si cambia la documentación, audita o empieza de nuevo.
- Autonomía basada en reglas. Merge en una rama de integración, suposiciones registradas, bloqueos que no detengan la cola, límites de reintentos y un resumen para quien es responsable del producto.
El resultado no es un equipo que prescinda de ti. Es un equipo en el que dejas de ser el cuello de botella y pasas a ser quien define las reglas del juego. Y eso, para quien construye productos, es lo que más importa.