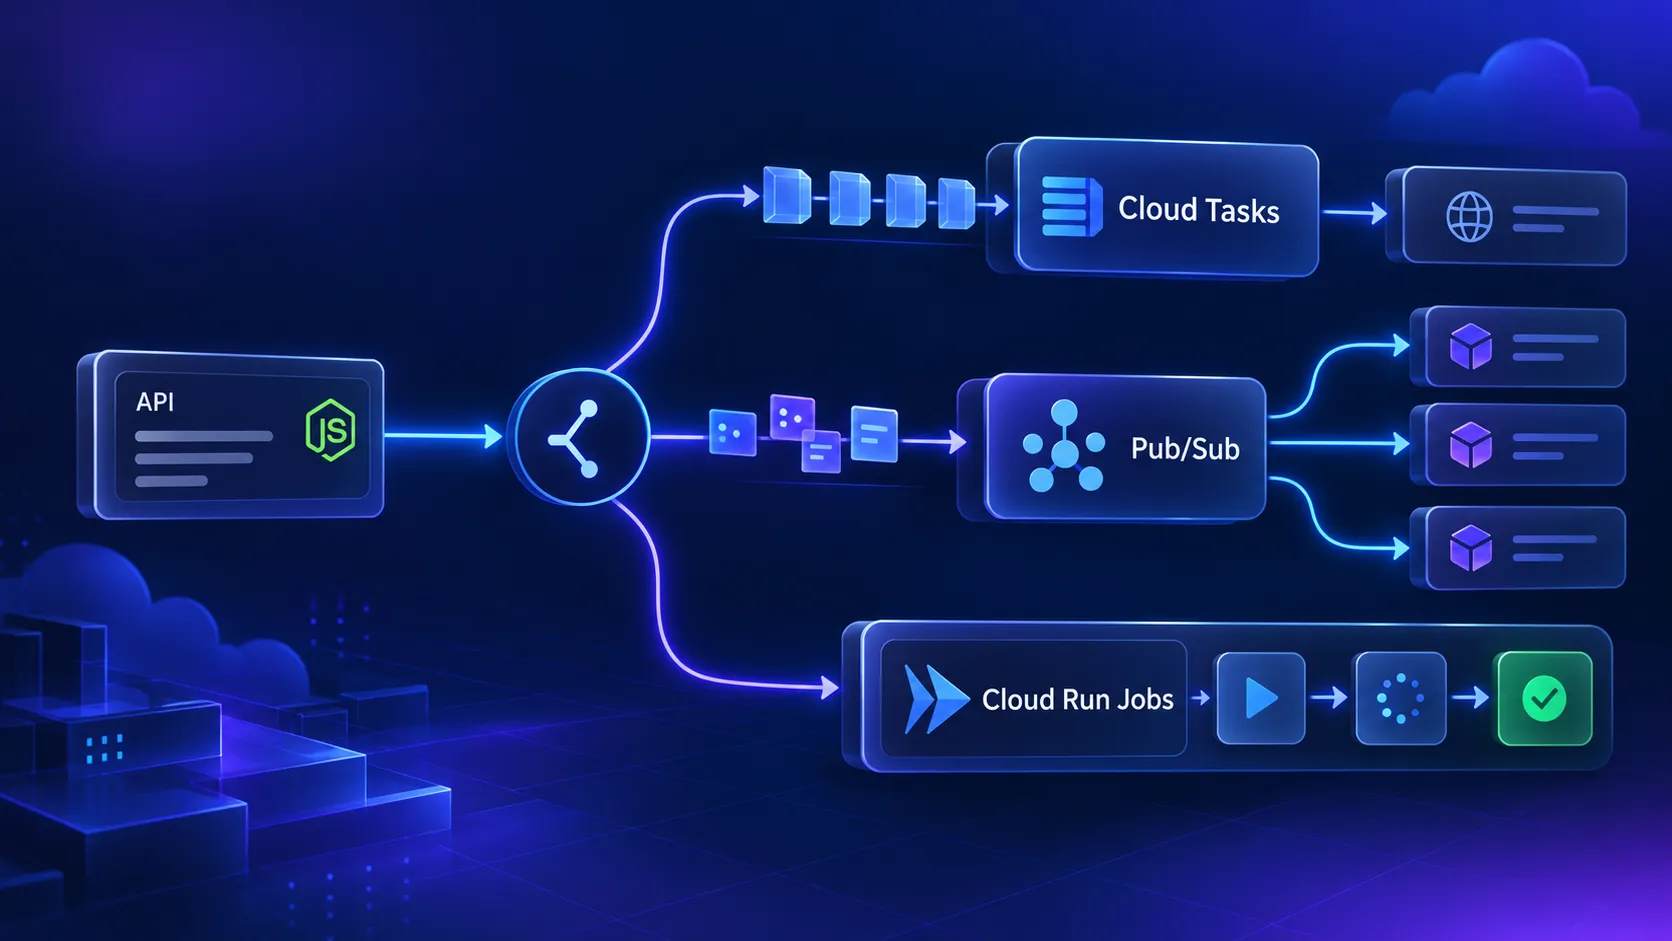
Uma API Node.js recebe uma requisição para criar uma cobrança. Ela valida os dados, grava no banco e, logo depois, precisa iniciar a cobrança em um provedor externo, notificar a pessoa responsável, registrar auditoria e garantir que, mais tarde, uma reconciliação confira se o estado interno bate com o estado do provedor.
Dá para fazer tudo no mesmo request HTTP? Até dá. Mas a API começa a parecer aquela pessoa que topa carregar mudança, buscar pizza, montar armário e ainda responder mensagem no grupo da família — tudo ao mesmo tempo. A resposta fica lenta, cada falha externa ameaça derrubar o fluxo inteiro e recuperar uma execução parcial vira um exercício de arqueologia.
É nesse ponto que muita gente pensa em processamento assíncrono com Node.js na GCP. Porém, a pergunta mais importante não é “qual fila usar?”. A pergunta é: estou pedindo uma ação, anunciando um fato ou executando um trabalho finito?
Essa diferença muda bastante a escolha entre Cloud Tasks, Pub/Sub e Cloud Run Jobs.
TL;DR
- Cloud Tasks é uma boa escolha quando sua aplicação precisa solicitar uma ação específica para um destino conhecido, como chamar um endpoint HTTP que inicia uma cobrança.
- Pub/Sub faz mais sentido quando o sistema precisa comunicar que algo aconteceu, permitindo que consumidores independentes reajam ao mesmo fato.
- Cloud Run Jobs é adequado para trabalho finito, batch, reprocessamento e rotinas que precisam começar, executar e terminar.
- Esses serviços não substituem necessariamente uns aos outros. Em arquiteturas maduras, os três podem coexistir no mesmo fluxo.
- O ponto central não é “usar fila”, mas explicitar o contrato operacional: quem produz, quem consome, como falha, como tenta de novo e como evita duplicidade.
Processamento assíncrono começa pelo contrato, não pela ferramenta
Antes de escolher um serviço da GCP, vale nomear o contrato entre as partes do sistema.
Neste artigo, vamos usar alguns termos de forma simples:
- Produtor é quem inicia a comunicação. Pode ser uma API Node.js que acabou de criar uma cobrança.
- Consumidor é quem reage a uma mensagem ou solicitação.
- Handler é o trecho de aplicação, geralmente um endpoint HTTP ou função de processamento, que recebe uma chamada e executa uma ação.
- Comando é uma solicitação explícita: “faça isso”.
- Evento é a comunicação de um fato que já aconteceu: “isso aconteceu”.
- Job é uma execução finita: começa, trabalha e termina com sucesso ou falha.
A decisão entre Cloud Tasks, Pub/Sub e Cloud Run Jobs depende menos da tecnologia em si e mais de três perguntas:
- Quem inicia o trabalho?
- Quem precisa reagir?
- Como a execução deve terminar?
Essas perguntas levam a três intenções arquiteturais diferentes:
- Comandar uma ação para um destino conhecido.
- Publicar um fato para interessados independentes.
- Executar trabalho finito que precisa chegar ao fim.
O erro comum é tratar “assíncrono” como sinônimo de “colocar em uma fila”. Às vezes você precisa de uma fila de ações HTTP controladas. Às vezes precisa de distribuição de eventos. Às vezes precisa de um processo batch. As três coisas podem envolver execução fora do request original, mas os contratos são diferentes.
A própria documentação da Google Cloud ajuda a separar essas ideias na comparação entre quando escolher Pub/Sub ou Cloud Tasks. A leitura vale especialmente para evitar uma escolha baseada apenas em “já usamos esse serviço no projeto”.
O principal pitfall aqui é escolher a ferramenta por familiaridade, sem explicitar o contrato entre produtor e consumidor. Isso costuma funcionar no primeiro caso de uso. O problema aparece quando chegam retentativas, múltiplos consumidores, reprocessamento e auditoria.
Cloud Tasks: quando uma aplicação precisa solicitar uma ação específica
Cloud Tasks representa bem o caso “preciso que esta ação seja executada por aquele destino”.
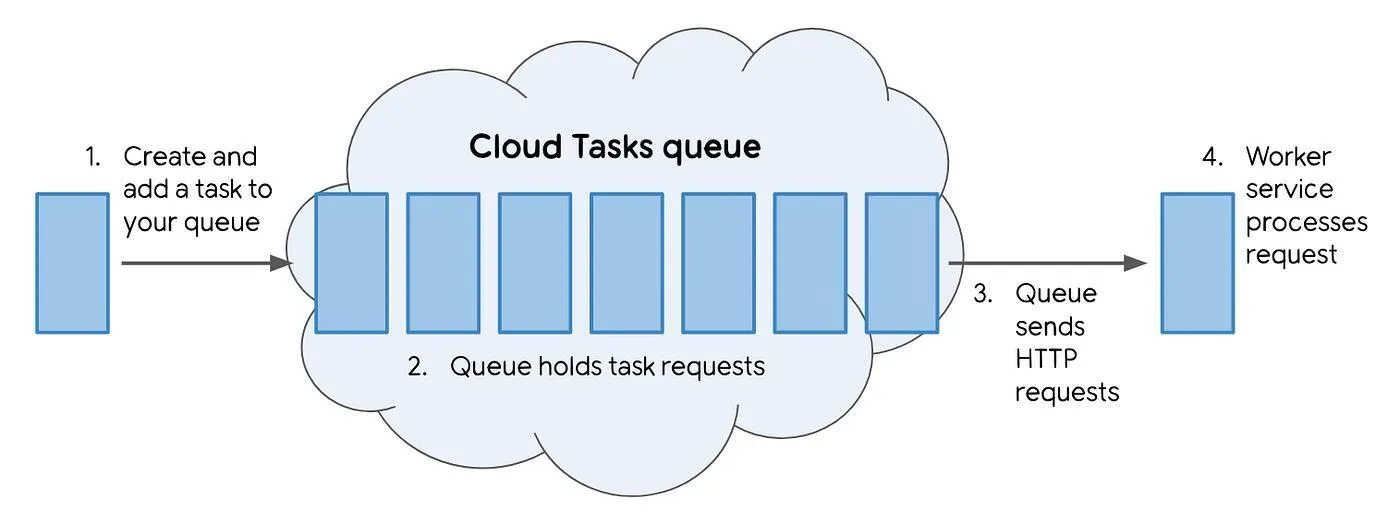
O modelo é direto: uma aplicação cria uma tarefa para ser entregue a um handler HTTP conhecido. Esse handler pode estar em um serviço Cloud Run, por exemplo. A tarefa carrega os dados necessários para o processamento, e a infraestrutura cuida da entrega, das retentativas e de controles como agendamento e taxa.
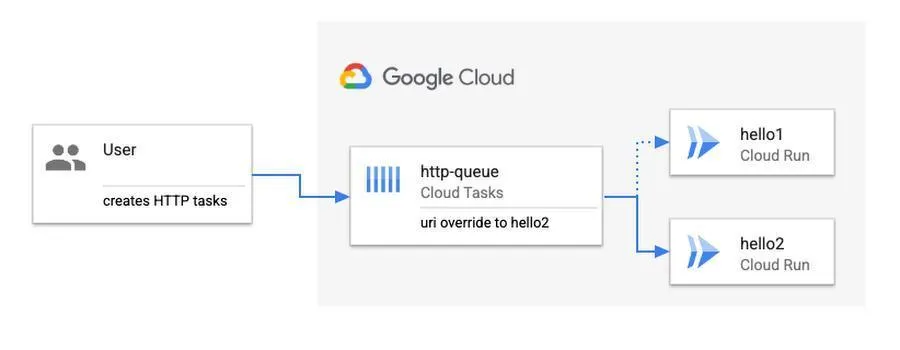
Em um fluxo de cobrança, isso pode aparecer assim:
- A API Node.js recebe uma requisição para criar uma cobrança.
- Ela persiste a cobrança com status inicial.
- Ela cria uma tarefa no Cloud Tasks para chamar um endpoint responsável por iniciar o pagamento no provedor externo.
- O request original responde sem esperar toda a comunicação com o provedor.
Esse modelo combina com cenários como:
- Cobrar uma fatura após a confirmação de uma cobrança.
- Enviar uma notificação para uma pessoa específica.
- Chamar uma integração externa que não deve bloquear a resposta da API.
- Executar uma ação em horário futuro.
- Controlar ritmo de chamadas para não pressionar um serviço interno ou parceiro externo.
Na prática, Cloud Tasks é útil quando você quer dizer: “entregue esta requisição HTTP para este handler, com estas regras de tentativa”.
A documentação oficial descreve a visão geral e o modelo de entrega do Cloud Tasks, incluindo conceitos de filas, tarefas, destinos e tentativas. Além disso, quando o destino é um serviço Cloud Run, a integração fica mais clara na documentação sobre uso de Cloud Tasks com Cloud Run.
Exemplo: iniciar uma cobrança sem bloquear a API
Imagine que a API Node.js criou uma cobrança e gerou um tentativa_pagamento_id.
Esse identificador é importante porque a tentativa pode ser executada mais de uma vez. O payload da tarefa poderia carregar algo como:
cobranca_idtentativa_pagamento_idcliente_id- valor
- provedor de pagamento
- timestamp de criação da tentativa
O handler HTTP chamado pelo Cloud Tasks recebe esses dados e solicita a cobrança ao provedor externo. Se tudo der certo, ele persiste o resultado e responde sucesso. Se houver uma falha transitória, como indisponibilidade do provedor, ele pode responder de modo que a tarefa seja tentada novamente.
O detalhe importante: o handler não deve assumir que será chamado uma única vez.
Trade-off: controle com acoplamento explícito
Cloud Tasks simplifica o fluxo quando o produtor sabe exatamente quem deve executar a ação. Isso é positivo: fica mais fácil rastrear a intenção, configurar retentativas e entender o destino.
Por outro lado, esse controle vem com acoplamento explícito. Quem cria a tarefa conhece o destino da ação. Se o endpoint mudar, se o contrato do payload mudar ou se a responsabilidade sair daquele serviço, o produtor provavelmente precisará ser alterado também.
Esse acoplamento não é necessariamente ruim. Em muitos fluxos, ele é desejável. Se a regra de negócio exige “inicie esta cobrança neste provedor”, fingir que isso é um evento genérico pode esconder uma decisão que deveria estar clara.
Controles relevantes sem transformar isso em tutorial
Cloud Tasks costuma ser interessante quando você precisa ajustar:
- Agendamento: executar uma tarefa em um horário futuro.
- Limite de taxa: controlar a velocidade de entrega das tarefas.
- Concorrência: evitar que muitos handlers rodem ao mesmo tempo.
- Retentativas: tentar novamente quando uma execução falha.
- Prazo de execução da requisição: definir limites para o tempo de resposta do handler.
Esses controles importam especialmente em integrações externas. Se um provedor de pagamento estiver instável, retentar agressivamente pode piorar o problema. Se a API parceira tiver limite de requisições, a fila pode funcionar como uma torneira: não resolve vazamento de lógica, mas ajuda a controlar a vazão.
Pitfall: esquecer duplicidade e efeitos parciais
O erro clássico é tratar o handler como se cada tarefa fosse entregue exatamente uma vez.
Na prática, a aplicação precisa estar preparada para chamadas repetidas, timeouts e efeitos parciais. Por exemplo:
- O provedor externo recebeu a cobrança, mas a resposta não chegou.
- O handler gravou parte do estado e falhou antes de concluir.
- A tarefa foi retentada após uma falha temporária.
- O mesmo
tentativa_pagamento_idapareceu novamente.
Por isso, o contrato precisa incluir idempotência. Voltaremos a esse ponto mais adiante, porque ele é menos um detalhe de infraestrutura e mais uma propriedade da operação de negócio.
Pub/Sub: quando o sistema precisa comunicar que algo aconteceu
Pub/Sub representa outro tipo de contrato: “algo aconteceu; quem se importa com isso pode reagir”.
Nesse modelo, um produtor publica uma mensagem em um tópico. Depois, assinaturas independentes recebem essa mensagem e seus consumidores processam conforme suas próprias responsabilidades.
Aqui, a diferença entre comando e evento é essencial:
- Comando: “envie esta cobrança para este destino”.
- Evento: “a cobrança foi confirmada”.
O comando espera que uma ação específica seja executada. O evento comunica um fato de negócio que já aconteceu.
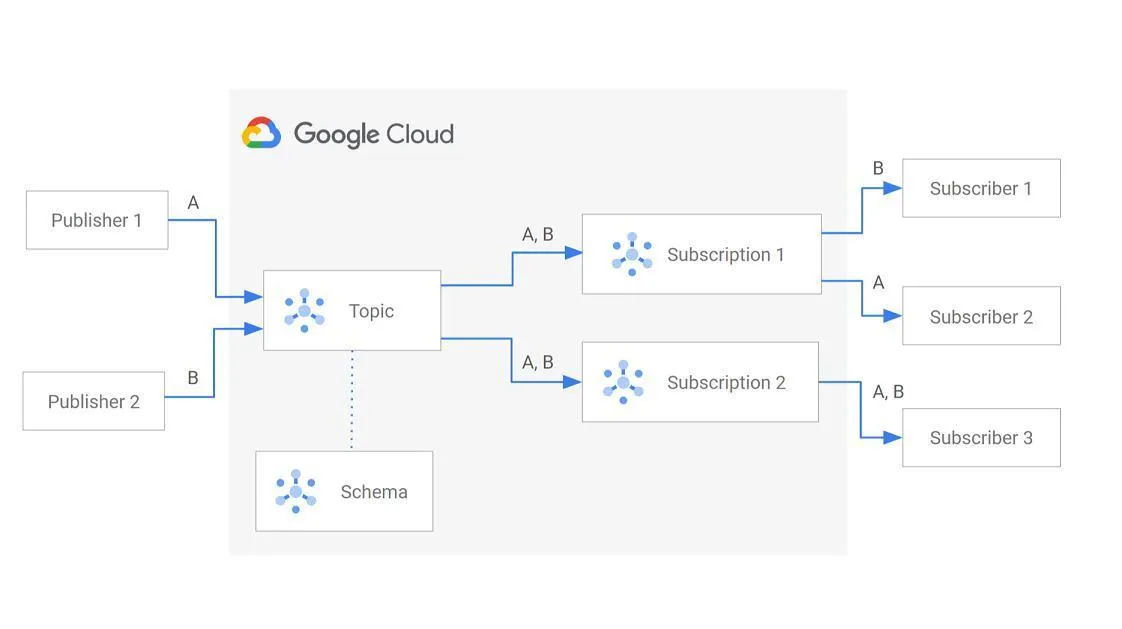
Em uma arquitetura com Pub/Sub, o serviço que confirma uma cobrança poderia publicar o evento cobranca.confirmada. A partir daí, consumidores independentes podem reagir:
- Um consumidor atualiza o saldo do cliente.
- Outro emite um documento fiscal.
- Outro alimenta uma comunicação transacional.
- Outro envia dados para uma base analítica.
O produtor do evento não precisa conhecer todos esses consumidores. Ele só precisa publicar um fato bem definido.
Exemplo: cobranca.criada e consumidores independentes
Suponha que uma cobrança foi criada e o serviço publique cobranca.criada.
Três assinaturas podem existir para esse mesmo evento:
- Uma assinatura processa uma reserva interna de saldo ou estoque.
- Outra dispara uma comunicação de boas-vindas ou aviso.
- Uma terceira alimenta uma base analítica.
Cada consumidor possui seu próprio ciclo de processamento. Se o consumidor analítico falhar, isso não precisa impedir que o consumidor de comunicação processe sua parte. Além disso, um novo consumidor pode ser criado no futuro sem alterar a API que publicou cobranca.criada.
Esse é o ponto forte do Pub/Sub: fan-out e independência entre consumidores.
Trade-off: menos acoplamento, mais disciplina de contrato
Pub/Sub reduz o acoplamento direto entre produtor e consumidores. O produtor publica o evento e não precisa saber quem vai reagir.
No entanto, esse desacoplamento cobra preço em outros lugares:
- O contrato da mensagem precisa ser estável e evolutivo.
- Consumidores precisam lidar com versões diferentes de payload.
- A observabilidade do fluxo distribuído fica mais importante.
- A consistência entre consumidores pode ser eventual.
- O rastreamento de uma cobrança ao longo de vários serviços exige correlação.
Em outras palavras: Pub/Sub remove algumas dependências diretas, mas não remove a necessidade de design. Ele só muda onde a complexidade aparece.
A documentação oficial sobre quando escolher Pub/Sub ou Cloud Tasks reforça justamente essa diferença entre entrega de eventos para consumidores e execução de tarefas direcionadas.
Pitfall: publicar comandos disfarçados de eventos
Um problema comum é usar Pub/Sub para publicar mensagens que, na prática, são instruções internas para um único serviço.
Por exemplo:
executarCobrancaNoProvedorXchamarEndpointDePagamentoenviarPayloadParaServicoY
Se só existe um consumidor, se o produtor sabe exatamente quem deve reagir e se a mensagem representa uma ação esperada, talvez você esteja modelando um comando como evento.
Isso não é proibido por alguma lei cósmica da arquitetura. Mas adiciona complexidade sem ganhar independência real. Você passa a lidar com tópicos, assinaturas, contratos de evento e rastreamento distribuído, mas continua com um fluxo fortemente direcionado.
Nesses casos, Cloud Tasks pode expressar melhor a intenção.
Cloud Run Jobs: quando o trabalho é finito e não cabe no ciclo de uma requisição
Cloud Run Jobs entra em cena quando você não quer manter um serviço HTTP disponível para responder requisições, mas sim executar um container até a conclusão de um trabalho.
A diferença é simples:
- Um Cloud Run service fica disponível para responder requisições.
- Um Cloud Run Job inicia uma execução, processa uma carga e termina com sucesso ou falha.
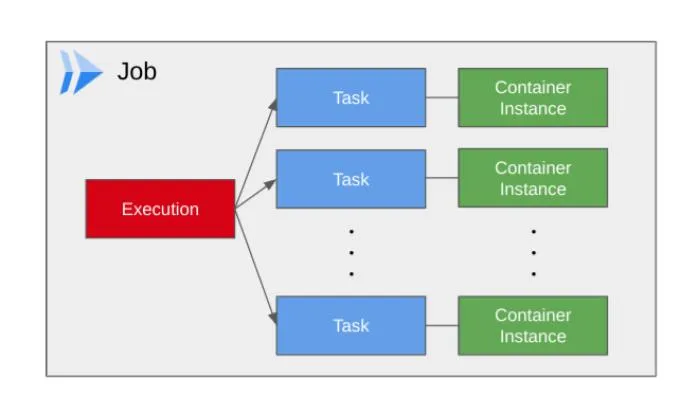
Isso combina com tarefas finitas, como:
- Reprocessar dados históricos.
- Gerar relatórios ou arquivos consolidados.
- Importar uma base recebida de um parceiro.
- Executar reconciliação de cobranças.
- Rodar migrações operacionais ou rotinas batch controladas.
A documentação oficial mostra como criar e executar Cloud Run Jobs, incluindo o modelo de execução baseado em container.
Exemplo: reconciliação de cobranças
Imagine que, ao longo do dia, sua aplicação iniciou cobranças em um provedor externo. Algumas foram confirmadas imediatamente. Outras ficaram pendentes. Outras podem ter tido timeout no retorno.
Uma rotina de reconciliação pode rodar como Cloud Run Job para:
- Buscar cobranças internas em estados relevantes.
- Consultar o provedor externo.
- Comparar o estado externo com o estado interno.
- Gerar uma lista de divergências.
- Atualizar estados quando a regra for segura.
- Encaminhar casos ambíguos para análise.
Esse trabalho não representa “uma mensagem para um consumidor”. Também não é necessariamente uma chamada HTTP curta. É um processo finito que precisa chegar ao fim — ou falhar de forma visível.
Paralelismo e divisão de trabalho
Cloud Run Jobs também traz uma decisão importante: processar tudo em uma única execução sequencial ou dividir a carga em múltiplas tarefas.
Dividir pode fazer sentido quando:
- O volume é grande.
- A carga pode ser particionada com segurança.
- Cada partição é independente.
- O tempo total de execução precisa ser reduzido.
- Uma falha em uma partição não deve invalidar todo o lote.
Por outro lado, manter uma execução sequencial pode ser melhor quando:
- O volume é administrável.
- A lógica depende de ordem.
- A consistência é mais importante que velocidade.
- A simplicidade operacional vale mais que paralelismo.
Nem todo batch precisa nascer distribuído. Às vezes, uma rotina simples, observável e reexecutável resolve melhor do que um desenho muito sofisticado. O truque é deixar claro o que acontece quando ela falha no meio.
Trade-off: ótimo para trabalho finito, ruim como fila improvisada
Cloud Run Jobs são apropriados para processamento finito e controlado. Porém, eles não substituem um mecanismo de entrega contínua de eventos nem uma fila de ações HTTP.
Um pitfall comum é usar um Job para cada evento individual de alto volume. Isso transforma uma necessidade de consumo contínuo em muitas execuções isoladas, possivelmente mais difíceis de acompanhar, limitar e reprocessar.
Se cada cobrança criada dispara um processamento individual curto e direcionado, Cloud Tasks ou Pub/Sub provavelmente expressam melhor o contrato. Se você precisa varrer uma base e reconciliar tudo o que ficou pendente, Cloud Run Jobs começa a fazer mais sentido.
Comparando escolhas de processamento assíncrono com Node.js na GCP: intenção, destino, consumidores e ciclo de execução
A tabela abaixo não é uma regra mecânica. Ela é um ponto de partida para conversa técnica.
| Critério | Cloud Tasks | Pub/Sub | Cloud Run Jobs |
|---|---|---|---|
| Intenção principal | Solicitar uma ação | Comunicar um evento | Concluir trabalho finito |
| Destino | Conhecido pelo produtor | Assinaturas independentes | Execução de container |
| Consumidores | Tipicamente um handler por tarefa | Um ou vários consumidores | Um processo ou conjunto de tarefas do job |
| Controle de agendamento | Forte | Depende do consumidor/arquitetura | Pode ser disparado sob demanda ou por outro mecanismo |
| Retentativas | Focadas na entrega da tarefa | Focadas no consumo por assinatura | Focadas na execução do trabalho |
| Melhor para | Chamadas HTTP confiáveis e adiadas | Fan-out e integração desacoplada | Batch, reprocessamento e rotinas finitas |
Algumas perguntas ajudam a decidir:
-
Estou pedindo uma ação ou anunciando um fato?
Se você está dizendo “faça isso”, pense em Cloud Tasks. Se está dizendo “isso aconteceu”, pense em Pub/Sub. -
O produtor conhece e deve controlar o destino?
Se sim, Cloud Tasks tende a ser mais explícito. Se não, Pub/Sub pode preservar melhor a independência. -
Um ou vários consumidores precisam reagir?
Se vários consumidores independentes precisam reagir ao mesmo fato, Pub/Sub costuma ser mais adequado. -
O trabalho cabe no tempo de uma requisição HTTP?
Se não cabe e representa um processo finito, Cloud Run Jobs pode ser uma opção melhor. -
Preciso agendar, limitar ritmo ou controlar concorrência?
Cloud Tasks se destaca quando a entrega de ações HTTP precisa desse tipo de controle. -
Se houver falha, o que significa reprocessar?
Reprocessar uma chamada de cobrança, reprocessar um eventocobranca.confirmadae reexecutar uma reconciliação são problemas diferentes.
O pitfall aqui é escolher Pub/Sub apenas por parecer mais “desacoplado”. Desacoplamento é útil quando há independência real. Quando o domínio precisa de uma ação explícita, rastreável e direcionada, esconder isso atrás de um evento pode atrapalhar mais do que ajudar.
Também vale lembrar que confiabilidade não depende só da ferramenta. Práticas de qualidade, testes e clareza de responsabilidades influenciam muito o resultado. Para uma visão complementar sobre qualidade no ciclo de desenvolvimento, vale a leitura sobre o papel do SDET no desenvolvimento moderno.
Retentativas, reprocessamento e idempotência: o contrato precisa sobreviver a falhas
Retentativa não significa “o sistema fará exatamente uma execução”. Significa apenas que a infraestrutura pode tentar de novo quando algo não foi confirmado como sucesso.
Isso muda a forma de desenhar operações de negócio.
Idempotência é a propriedade de uma operação produzir o mesmo efeito esperado mesmo quando executada mais de uma vez com a mesma intenção. Em português menos formal: se a mesma tentativa for processada duas vezes, você não deve criar duas cobranças por acidente.
Alguns exemplos:
- Reexecutar a mesma cobrança não pode gerar uma segunda cobrança indevida.
- Reenviar a mesma notificação pode exigir uma chave de deduplicação ou um identificador de entrega.
- Reprocessar
cobranca.confirmadanão deve corromper o estado agregado. - Reexecutar uma reconciliação não deve duplicar divergências já registradas.
Exemplo: tentativa_pagamento_id
Em um fluxo de cobrança, use um identificador como tentativa_pagamento_id.
A primeira execução cria ou atualiza a tentativa de pagamento associada a esse identificador. Se a tarefa for entregue novamente, o handler consulta o estado dessa tentativa antes de chamar o provedor ou antes de persistir um novo resultado.
Assim, múltiplas tentativas da infraestrutura atualizam a mesma tentativa de negócio, em vez de criar novas cobranças.
Esse identificador também ajuda no diagnóstico. Quando alguém investiga uma falha, é melhor procurar por tentativa_pagamento_id do que tentar reconstruir o fluxo apenas por timestamp e logs espalhados.
Três decisões precisam ser explícitas
Ao desenhar retentativas e reprocessamento, evite deixar tudo no “a plataforma resolve”. A plataforma ajuda, mas a regra de negócio ainda é sua.
Defina explicitamente:
-
Quando tentar novamente
Falhas transitórias, timeouts e indisponibilidade temporária podem justificar retentativa. Erros de validação, payload inválido ou estado incompatível talvez não. -
Quando interromper tentativas e encaminhar para análise
Nem toda falha deve ser repetida indefinidamente. Algumas precisam virar pendência operacional, alerta ou item de correção. -
Como reprocessar depois de corrigir uma falha sistêmica
Se um bug afetou centenas de mensagens ou cobranças, como você reexecuta o lote? Por evento? Por tarefa? Por Job? Com qual critério de seleção?
Trade-off: automação aumenta responsabilidade
Quanto mais automática a retentativa, maior a necessidade de proteger serviços externos contra duplicidade, sobrecarga e efeitos irreversíveis.
Isso aparece bastante em pagamentos e notificações. Uma retentativa inocente pode virar:
- cobrança duplicada;
- e-mail repetido;
- chamada excessiva para API parceira;
- estado interno divergente;
- retrabalho operacional.
Portanto, não retorne sucesso para a infraestrutura antes de garantir que o estado essencial foi persistido. Se o handler responde sucesso cedo demais e falha logo depois, talvez você perca a chance de reprocessar automaticamente.
Além disso, payloads devem carregar identificadores de negócio e metadados suficientes para diagnóstico. Logs ajudam, mas não devem ser a única forma de entender uma falha. Em sistemas distribuídos, depender exclusivamente de log é como procurar chave no escuro porque “uma hora ela aparece”.
Arquiteturas combinadas: os três serviços podem coexistir
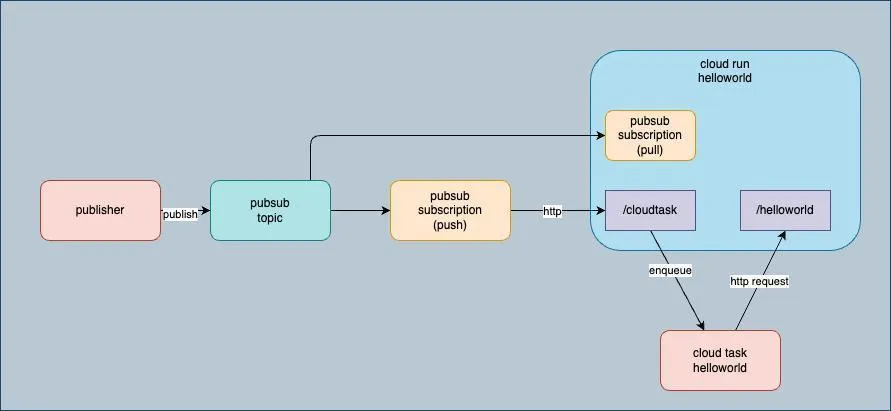
Cloud Tasks, Pub/Sub e Cloud Run Jobs não precisam competir entre si. Eles representam contratos operacionais diferentes.
Em um fluxo de cobrança mais completo, os três podem aparecer naturalmente.
Exemplo: cobrança com ação, evento e reconciliação
Um desenho possível:
- A API registra a cobrança e cria uma tarefa no Cloud Tasks para iniciar a cobrança no provedor externo.
- O handler processa a tentativa usando
tentativa_pagamento_id. - Após confirmação, o serviço publica
cobranca.confirmadano Pub/Sub. - Consumidores independentes reagem ao evento: comunicação, auditoria, atualização financeira ou analytics.
- Uma rotina periódica roda como Cloud Run Job para reconciliar registros internos com o provedor de pagamento.
Nesse fluxo:
- Cloud Tasks expressa a ação direcionada: iniciar cobrança.
- Pub/Sub expressa o fato de negócio:
cobranca.confirmada. - Cloud Run Jobs expressa o trabalho finito: reconciliar divergências.
Cada serviço aparece porque há uma intenção diferente, não porque alguém quis usar três produtos no mesmo diagrama para ele ficar mais bonito.
Exemplo: integração com API parceira
Outro fluxo possível:
- Um evento
cobranca.criadaé publicado no Pub/Sub. - Um consumidor decide que aquela cobrança precisa ser enviada a uma API parceira.
- Esse consumidor cria tarefas no Cloud Tasks para respeitar limite de requisições e controlar retentativas.
- Falhas acumuladas são analisadas e reprocessadas por um Cloud Run Job.
Aqui, Pub/Sub distribui o fato, Cloud Tasks controla chamadas direcionadas e Cloud Run Jobs ajuda em reprocessamentos de lote.
Esse tipo de combinação costuma ser mais honesto do que tentar resolver tudo com um único mecanismo. O ponto é preservar clareza: cada mensagem precisa ter intenção, destino e comportamento de falha compreensíveis.
Árvore de decisão curta
Use esta árvore como checklist mental:
-
Preciso solicitar uma ação controlada para um destino conhecido?
Considere Cloud Tasks. -
Preciso comunicar um fato relevante para interessados independentes?
Considere Pub/Sub. -
Preciso executar e concluir um trabalho finito, batch ou reprocessamento controlado?
Considere Cloud Run Jobs. -
Tenho mais de uma dessas necessidades no mesmo fluxo?
Combine os serviços, mantendo contratos claros.
A regra memorável é:
Escolha Cloud Tasks quando precisa solicitar uma ação controlada; Pub/Sub quando precisa comunicar um fato a interessados independentes; Cloud Run Jobs quando precisa executar e concluir um trabalho finito.
Uma arquitetura madura pode combinar os três serviços no mesmo fluxo, desde que a intenção de cada mensagem e o comportamento em caso de falha estejam claros.
Se quiser discutir decisões arquiteturais e trade-offs com outros profissionais, participe da comunidade SCCB. Para acompanhar encontros e conversas técnicas, veja os próximos eventos da SCCB.