Eu queria um fluxo simples de descrever e difícil de montar: um agente faz o papel de PO e escreve as issues comigo, outro implementa, outro revisa, outro corrige, e o projeto segue evoluindo. Foi com esse objetivo que comecei a estruturar agentes no Claude Code para o Hive, um app de marketing para pequenos negócios de serviço (manicure, cílios, fotografia). O app mobile é em React Native + Expo, e o backend é um .NET que já existia e que decidimos reaproveitar, sem reescrever.
Este artigo não é sobre a promessa. É sobre o que precisou existir para isso funcionar de verdade: como os agentes se comunicam (spoiler: não se comunicam), onde fica a memória entre eles, que limites cada papel precisa ter e o que muda quando você decide tirar o humano do meio.
O que é, na prática, um agente no Claude Code
Um agente no Claude Code (o nome oficial é subagent) é um arquivo Markdown dentro de .claude/agents/. O cabeçalho diz quem ele é, quando usar e quais ferramentas ele pode tocar. O corpo é o manual do papel.
---
name: hive-developer
description: Implements one approved Hive feature on a dedicated branch and opens a PR. Use for Linear issues labeled role:implementation.
tools: Read, Write, Edit, Grep, Glob, Bash
---

# Role — Developer

Implement the approved feature on a dedicated branch and open a PR.

## Required inputs

The orchestrator gives you the Product and Architecture outputs. Do not silently
reinterpret their acceptance criteria. If they are missing or contradictory,
stop and report it — do not guess.
Duas propriedades fazem toda a diferença:
- Contexto isolado. Cada agente começa do zero. Ele não vê a conversa que você teve antes, nem o que outro agente pensou. Isso é ótimo para foco e péssimo se você esperava que ele "lembrasse".
- Ferramentas por papel. O revisor do Hive tem só leitura (
Read, Grep, Glob, Bash). Ele não consegue "dar uma arrumadinha" no código, e isso é proposital: quem revisa não deveria ser quem corrige.
Um detalhe que me pegou: o subagente não conversa com você no meio da tarefa. Ele recebe o pedido, trabalha até o fim e devolve um resultado. Se a ideia é um PO com quem você discute as issues em várias idas e vindas, o lugar certo é um comando (slash command) que roda na sessão principal, não um subagente.
Agentes no Claude Code não conversam: alguém precisa orquestrar
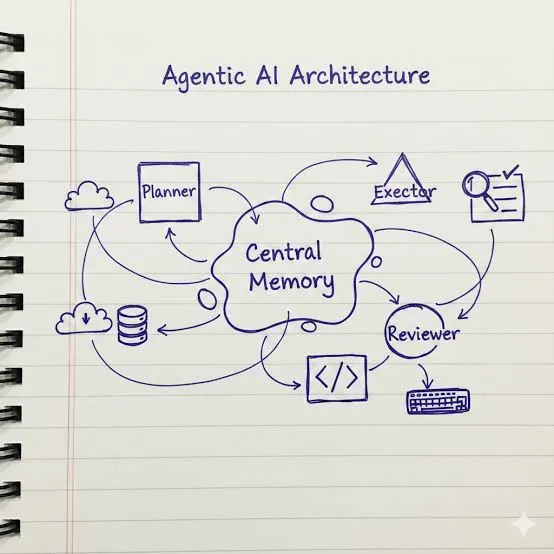
A imagem mental de "um agente manda para o outro" é sedutora, mas não é assim que funciona. Os agentes não trocam mensagens entre si. Quem coordena é a sessão principal, que faz o papel de orquestrador: chama um agente, recebe o resultado, decide o próximo passo e passa o que for necessário adiante.
No Hive, o orquestrador ganhou dois comandos:
/hive-next: mostra quais issues já podem rodar (sem bloqueios pendentes)./hive-issue HIVE-123: carrega a issue, descobre o papel pelo label e chama o agente certo.
O roteamento é uma tabela, sem mágica:
| Label | Agente |
|---|---|
role:planning |
hive-planning |
role:product |
hive-product |
role:architecture |
hive-architect |
role:implementation |
hive-developer |
role:qa |
hive-qa |
role:review |
hive-reviewer |
role:fix |
hive-fix |
role:gate |
o próprio orquestrador avalia |
Se a issue não tem label de papel, ou tem dois, o orquestrador não adivinha: para e pergunta. Essa é a primeira regra que eu levaria para qualquer projeto: ambiguidade no roteamento é bug, não um caso para resolver no improviso.
Linear como memória compartilhada entre os agentes
Se nenhum agente vê a sessão do outro, a informação precisa morar em algum lugar fora do chat. No Hive, esse lugar é o Linear.
O modelo é direto: uma issue = uma etapa = uma execução. Cada etapa termina postando um comentário estruturado (STAGE_RESULT:, VALIDATION_RESULT:, REVIEW_RESULT:). A etapa seguinte depende da anterior pela relação blocked_by e, antes de rodar, o orquestrador busca esses comentários e entrega ao próximo agente na íntegra.
Isso resolve três problemas de uma vez:
- Rastreabilidade. Dá para abrir uma funcionalidade e ver o que o PO decidiu, o que a arquitetura propôs, o que o QA reprovou e por quê.
- Retomada. Se a sessão cai, nada se perde: o estado está no Linear, não na memória do modelo.
- Independência. O QA recebe os critérios de aceite do PO, não a opinião do dev sobre o próprio código.
O trade-off apareceu rápido: no desenho original, cada funcionalidade virava seis issues (produto, arquitetura, implementação, QA, revisão, gate). É muito rastreável e também muito barulho. Mais adiante voltamos a isso.
Os papéis e por que cada um precisa de limites
O time do Hive tem sete papéis. O que torna cada um útil não é o que ele faz, mas o que ele não pode fazer:
- Planejamento propõe o grafo de issues com dependências. Quem cria as issues no Linear é o orquestrador, e só depois de aprovação.
- Produto define comportamento e critérios de aceite a partir do PRD. Não escreve código.
- Arquitetura propõe o menor plano técnico seguro e incremental. Não implementa.
- Desenvolvimento implementa numa branch dedicada e abre o PR. Se os critérios forem contraditórios, para e reporta em vez de "interpretar".
- QA tem uma missão desconfortável de propósito: tentar provar que a implementação não atende aos critérios. Nunca corrige.
- Revisão faz code review sênior e independente. Só lê.
- Correção trata apenas os apontamentos validados de QA e revisão, na branch existente.
Por cima de todos estão as regras de engenharia do projeto, num arquivo que os agentes consultam por seção: multi-tenancy obrigatória (o tenant é resolvido no servidor, nunca vem do cliente), segredos fora do git, e a proibição de apagar ou enfraquecer um teste que falha só para o CI ficar verde.
Separar quem implementa de quem valida é o que transforma "vários prompts" em um time. Um agente que escreve e aprova o próprio código é só um agente com mais etapas.
Economia de contexto: o PRD de 2.700 linhas
O PRD do Hive tem cerca de 2.700 linhas. Na automação anterior, cada etapa lia o documento inteiro, e esse foi o maior desperdício de orçamento do processo todo. O pior é que não ajudava: o agente recebia um oceano de contexto para responder a uma pergunta sobre uma seção.
A solução foi simples e virou regra no CLAUDE.md do projeto:
- Existe um
prd-index.mdcom as seções e suas faixas de linha. - O agente lê o índice, acha a seção e lê só aquele trecho.
sed -n '2602,2707p' docs/product/hive-product-prd-v6.md
A lição geral: em fluxo multiagente, contexto não é de graça nem neutro. Cada agente deve receber o mínimo necessário para decidir bem, e o resto deve estar a uma consulta de distância.
Quando a documentação muda, o backlog apodrece
Esse foi o problema mais traiçoeiro, porque não aparece como erro.
Issues são escritas uma vez e ficam semanas paradas. Enquanto isso, o produto muda. No Hive, o escopo mobile foi reduzido para iOS primeiro, mas uma issue de validação ainda exigia teste no Android. Se ela rodasse, o QA reprovaria uma implementação correta, o fluxo abriria um ciclo de correção e um agente gastaria tempo "consertando" código que estava certo.
Depois veio uma mudança maior: o plano do Hive Studio (gravação com teleprompter, envio por cena, edição automática de vídeo) passou a ser a fonte mais atual do produto, e nenhuma das dezenas de issues abertas falava dele.
Duas práticas saíram daí:
- Quando a documentação muda, audite o backlog antes de rodar qualquer etapa. Seções renumeradas, escopo superado e critérios que contradizem decisões mais novas são os suspeitos de sempre.
- Às vezes, o melhor é recomeçar o backlog. Revisar dezenas de issues que ninguém sabe mais para onde levam custa mais do que abrir um projeto novo, ancorado no documento atual, e deixar o antigo como histórico.
Do humano no loop ao loop sem humano: as decisões que importam
O desenho original tinha um humano presente: dúvidas de produto iam para "Human Review", e só um humano fazia merge. Funciona, mas não escala para o que eu queria, um fluxo que continua evoluindo o app sozinho e me manda um resumo do que foi feito.
Tirar o humano do loop não é apagar uma etapa. É substituir julgamento humano por regras explícitas. Estas são as que eu considero essenciais:
- Onde o merge acontece. Se ninguém faz merge, cada funcionalidade nova é construída sem a anterior e o loop trava em uma pilha de PRs. A saída que faz sentido é merge automático em
developdepois de QA e revisão aprovarem, commastercontinuando exclusivamente humana. A autonomia fica num ramo de integração, não em produção. - Dúvida de produto vira suposição registrada. O PO decide, escreve a decisão na issue com um label de suposição e segue. Você não aprova antes, mas consegue auditar depois.
- Bloqueio não para a fila. Simulador indisponível, credencial ausente, serviço fora do ar: a issue é marcada como bloqueada, o motivo fica registrado uma única vez e o loop passa para a próxima. Tentar de novo um bloqueio externo que não mudou é desperdício.
- Limite de ciclos de correção. Se QA ou revisão reprovam mais de duas vezes, a issue sai da fila. Um ciclo infinito de correção é o jeito mais caro de descobrir que a especificação estava errada.
- A fila se renova. Quando não há nada pronto para rodar, o PO lê o plano atual e o código e cria as próximas poucas issues. É isso que faz o fluxo "não parar" sem inventar funcionalidades futuras por conta própria.
- Resumo para o humano. A cada entrega, uma mensagem curta: o que foi feito, o PR e as suposições que o PO assumiu. Você sai do caminho crítico, mas não sai do controle.
E uma regra operacional: nunca rode duas automações contra o mesmo backlog. O Hive tinha uma automação anterior; com as duas ligadas, elas brigariam pelo status das mesmas issues.
O que eu levaria para qualquer projeto
Se eu fosse começar hoje um fluxo com agentes no Claude Code em outro produto, eu começaria por aqui:
- Agentes pequenos, com limites claros. O valor está no que cada papel não pode fazer.
- Handoff fora do chat. Uma ferramenta de gestão (Linear, Jira, GitHub Issues) com comentários estruturados é a memória do time.
- Orquestrador explícito. Roteamento por regra, e parada quando houver ambiguidade.
- Contexto sob demanda. Índices e leitura por trecho, nunca documentos inteiros por padrão.
- Backlog vivo. Mudou a documentação, audite ou recomece.
- Autonomia por regras. Merge em ramo de integração, suposições registradas, bloqueios que não travam a fila, limites de retentativa e um resumo para quem é dono do produto.
O resultado não é um time que dispensa você. É um time em que você deixa de ser o gargalo e passa a ser quem define as regras do jogo, e isso, para quem constrói produto, é a parte que mais importa.