El problema del que nadie publica en LinkedIn
En una sola semana, derribamos el banco de producción dos veces. No fue por falta de backup: había backups diarios y probados. El problema era que, cuando el nodo principal cayera, nadie sabía con certeza cómo levantar el banco en el otro nodo sin corromper nada y, preferiblemente, de forma automática.
PostgreSQL es single-primary
En la replicación por streaming, un nodo escribe y transmite los cambios a réplicas de solo lectura. La replicación unidireccional no es una limitación: es la garantía contra la corrupción. El failover elige un nuevo primary; el anterior debe volver a sincronizarse antes de regresar (la «danza del switchback»).
Dos nodos no bastan: split-brain
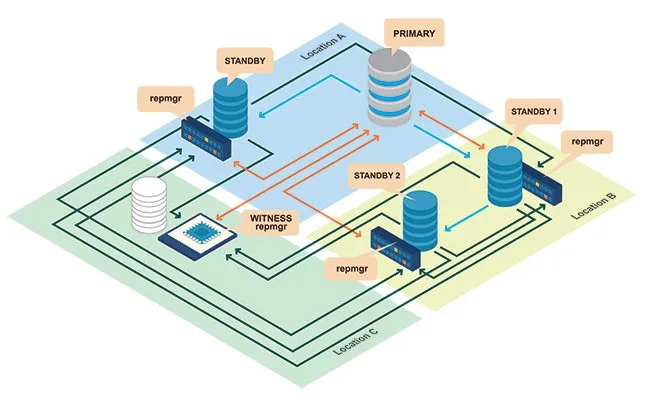
Con dos nodos, una partición de red se convierte en un cara o cruz: sin mayoría, ninguna herramienta puede decidir con seguridad cuál es el primary. La solución es aritmética: un tercer voto (witness). En nuestro caso, un droplet barato que solo vota.
Patroni: solución de plataforma
Se apoya en un DCS (etcd/Consul/ZooKeeper) y realiza fencing automático: quien pierde el quórum se degrada por sí solo. Cuesta Python (más RAM), envuelve PostgreSQL y añade etcd (+HAProxy en Docker). Pero etcd no es ZooKeeper: está escrito en Go y es ligero (~50 MB). Vale la pena cuando vas a estandarizar la alta disponibilidad en varios servicios.
repmgr: el bolt-on
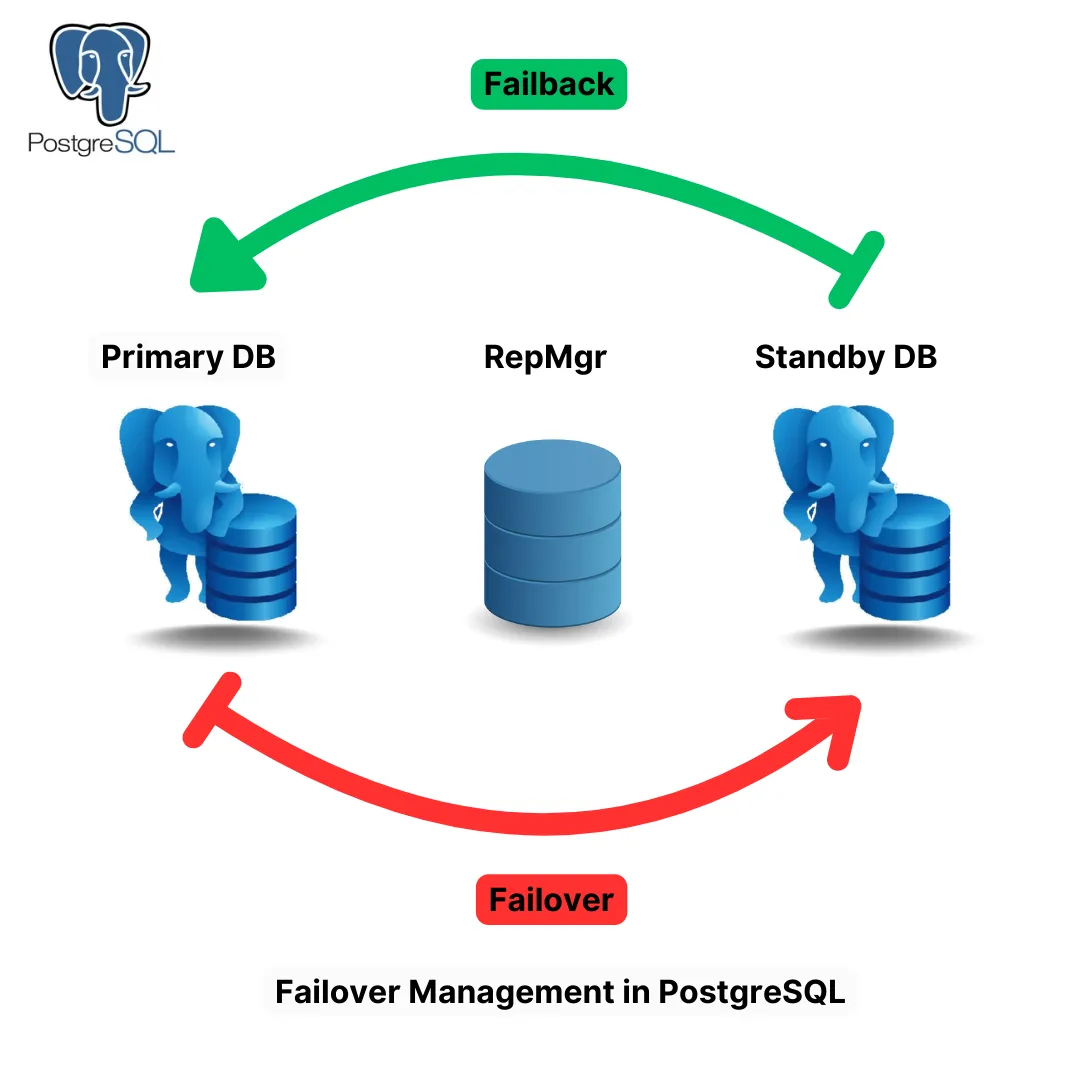
Escrito en C (ligero), utiliza witness + repmgrd, sin un DCS externo y junto a tu PostgreSQL. repmgr standby switchover y repmgr node rejoin --force-rewind permiten hacer el switchback con elegancia. El fencing depende más de ti, pero, con el witness, repmgrd exige una mayoría antes de promover un nodo. En Docker, necesitas una imagen con la extensión repmgr; aun así, es mucho menos invasivo que Patroni.
El enrutamiento mediante DNS cambia las reglas
La aplicación y la base de datos son por nodo: cada aplicación se comunica con la base de datos local y el DNS decide quién atiende. Por lo tanto, no hace falta HAProxy: el failover consiste en promover la base de datos local y cambiar el DNS. La parte más pesada de Patroni se convierte en un peso muerto.
¿Y si perdemos datos?
Casi ninguno. El contenido (artículos, imágenes y autores) vive en MinIO, que está replicado. Durante la caída, solo se escribe el contador de visitas; con la replicación mediante slots, hay 0 bytes de retraso. El peligro real nunca fue el lag, sino un switchover mal ejecutado. Es un riesgo operativo que se resuelve con una buena herramienta y un witness.
La decisión
repmgr + el droplet como witness: funciona con el PostgreSQL actual, sin etcd y sin tocar el CD, con failover automático y switchover/rejoin compatibles, aprovechando el cambio de DNS. Patroni queda para el día en que la alta disponibilidad se convierta en una necesidad de plataforma.
Cierre
La alta disponibilidad consiste en elegir la herramienta que puedas mantener y en la que confíes a las 3 de la mañana. Para un equipo pequeño, casi siempre es la más sencilla que resuelve el problema correcto: el split-brain. Un tercer voto barato vale más que mil líneas de YAML que no puedes depurar bajo presión.