A dor que ninguém posta no LinkedIn
Numa semana só, derrubamos o banco de produção duas vezes. Não foi falta de backup — tinha, diário e testado. O problema: quando o nó principal caísse, ninguém sabia, com confiança, como subir o banco no outro nó sem corromper nada, e de preferência automaticamente.
PostgreSQL é single-primary
Na replicação de streaming, um nó escreve e transmite para réplicas somente-leitura. Replicação unidirecional não é limitação — é a garantia contra corrupção. Failover elege um novo primary; o antigo precisa re-sincronizar antes de voltar (a "dança do switchback").
Dois nós não bastam: split-brain
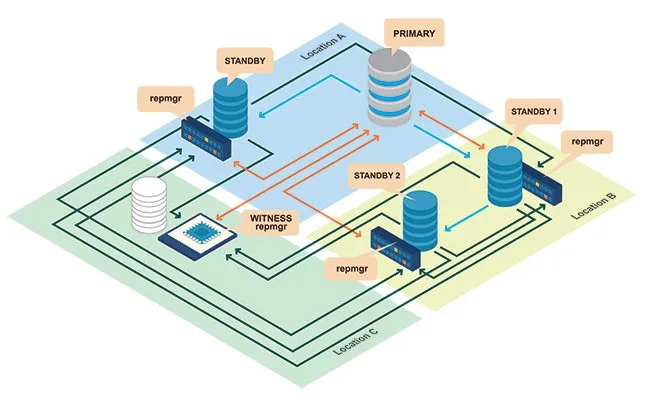
Com dois nós, uma partição vira cara-ou-coroa: sem maioria, nenhuma ferramenta decide com segurança quem é primary. A saída é aritmética: um terceiro voto (witness). No nosso caso, um droplet barato que só vota.
Patroni: solução de plataforma
Apoia-se num DCS (etcd/Consul/ZooKeeper) e faz fencing automático: quem perde quórum se rebaixa sozinho. Custa Python (mais RAM), embrulha o Postgres e adiciona etcd (+HAProxy em Docker). Mas etcd não é ZooKeeper — é Go leve (~50MB). Vale quando você vai padronizar HA em vários serviços.
repmgr: o bolt-on
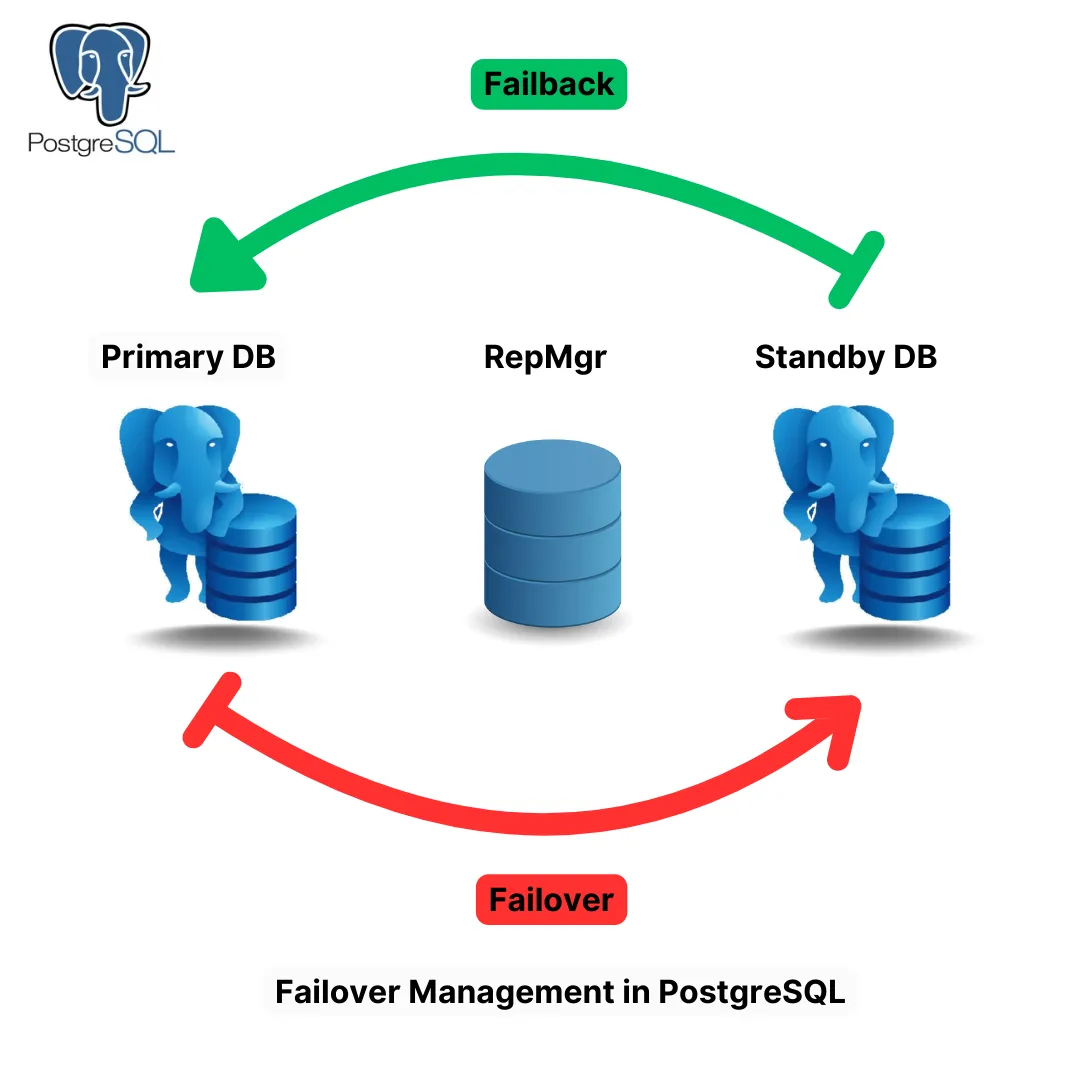
Em C (leve), usa witness + repmgrd, sem DCS externo, ao lado do seu Postgres. repmgr standby switchover e repmgr node rejoin --force-rewind dão o switchback com elegância. O fencing é mais por sua conta, mas com o witness o repmgrd exige maioria antes de promover. Em Docker, precisa de imagem com a extensão repmgr — ainda assim, bem menos invasivo que Patroni.
Roteamento por DNS muda o jogo
App e banco são por-nó: cada app fala com o banco local, e o DNS decide quem atende. Logo, nada de HAProxy: failover é promover o banco local + trocar o DNS. A parte mais pesada do Patroni vira peso morto.
E perder dados?
Quase zero. Conteúdo (artigos, imagens, autores) vive no MinIO, replicado. Durante a queda, só se escreve contador de visita; com replicação por slot, 0 bytes de atraso. O perigo real nunca foi o lag — é o switchover mal feito. Isso é risco operacional, resolvido por ferramenta boa + witness.
A decisão
repmgr + o droplet como witness: vive no Postgres atual, sem etcd, sem tocar no CD, com failover automático + switchover/rejoin suportados, reaproveitando a troca de DNS. Patroni fica para o dia em que HA virar necessidade de plataforma.
Fecho
HA é escolher a ferramenta que você mantém e confia às 3 da manhã. Para time pequeno, quase sempre é a mais simples que resolve o problema certo — split-brain. Um terceiro voto barato vale mais que mil linhas de YAML que você não depura sob pressão.