Frases como “o pagamento não pode ser processado duas vezes”, “a API precisa continuar disponível” ou “a confirmação do pedido deve ser rápida” são requisitos importantes. Mas, sozinhas, elas ainda não dizem qual arquitetura usar, qual infraestrutura declarar ou qual comportamento observar em produção.
Antes de escolher fila, Kubernetes, cache, banco ou qualquer outra ferramenta, precisamos entender onde estamos pisando. Essa aplicação atende poucas pessoas ou milhares? É algo novo ou já tem gargalo? Depende de serviço externo? Pode ficar indisponível por quanto tempo? No fim, contexto importa.
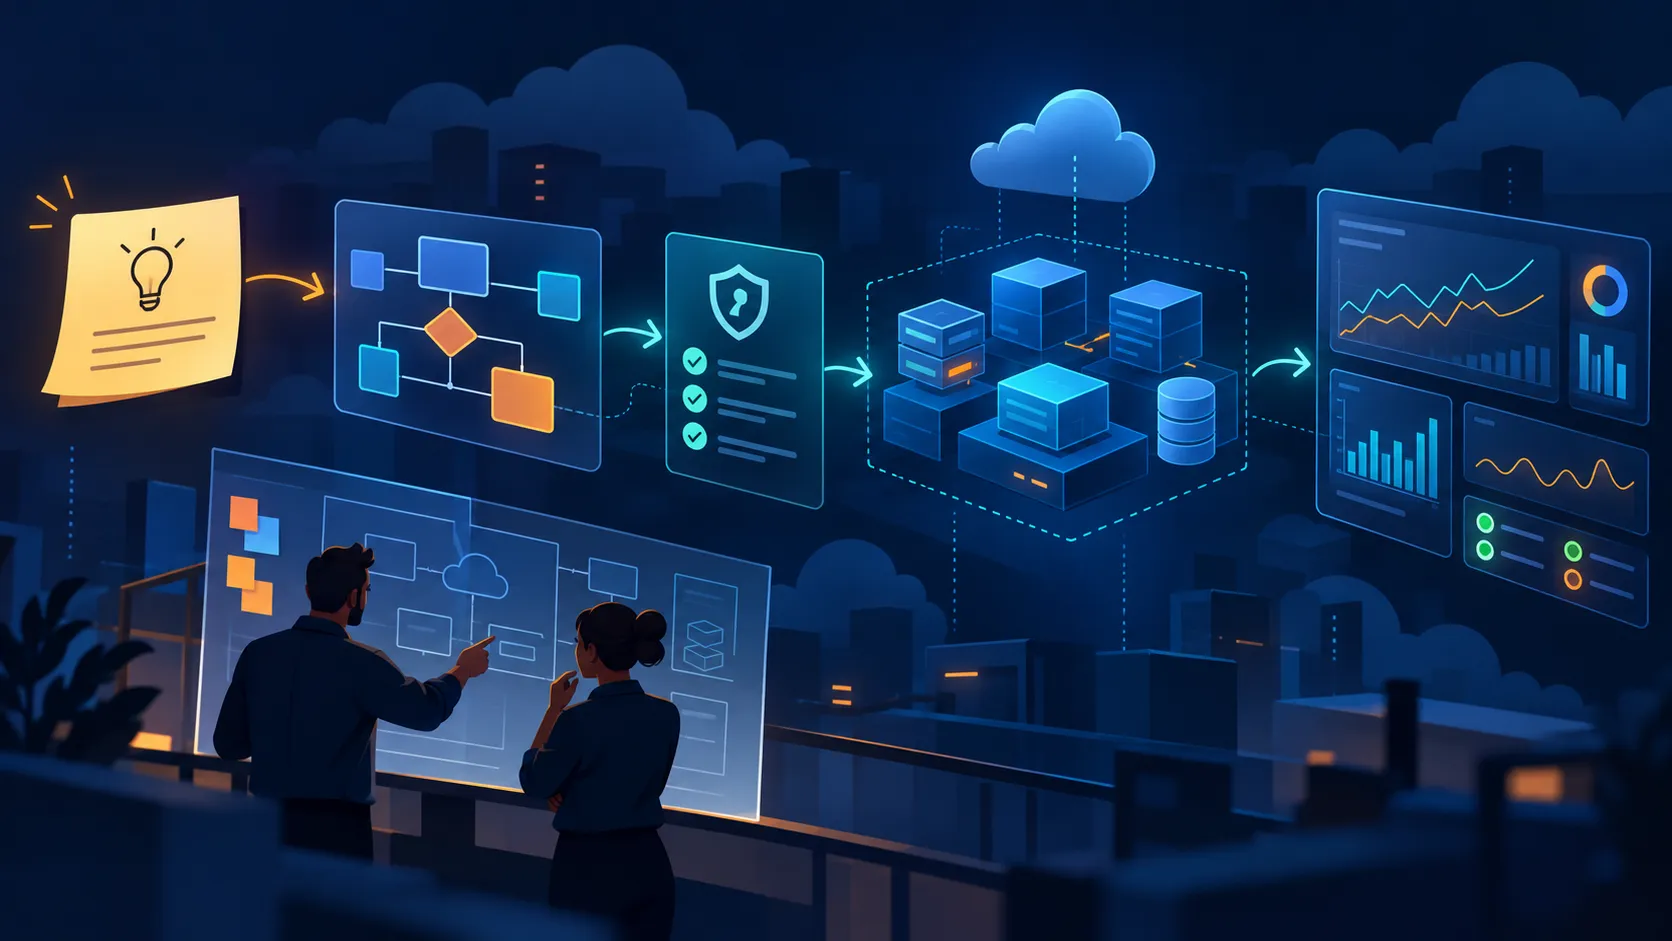
O ponto deste artigo é defender um modelo mental: transformar requisitos de negócio em intenções técnicas para sistemas distribuídos. Ou seja, descrever qual condição o sistema precisa sustentar, sob quais restrições, como isso aparece no ambiente e como vamos perceber quando deixou de ser verdade.
A melhor solução não é necessariamente a mais complexa. É a que resolve o problema de forma simples, mantém o sistema confiável e não vira mais uma coisa difícil de manter, corrigir e explicar depois.
TL;DR
- Requisito de negócio não é a mesma coisa que decisão técnica.
- “Não cobrar duas vezes” pode virar uma intenção técnica como: “uma mesma solicitação de pagamento deve produzir, no máximo, uma cobrança confirmada”.
- Política define limites e condições: escopo, prazos, autorização, tolerância a falhas e degradação aceitável.
- Estado desejado é uma forma declarada de representar uma condição que o ambiente deve manter.
- Observabilidade, testes e reconciliação fecham o ciclo: sem validação, a intenção vira só uma frase bonita.
- Terraform e Docker Compose ajudam a declarar ambientes esperados; Kubernetes e Intent-Based Networking deixam mais explícito o ciclo de observar estado atual e agir diante de desvios.
- A pergunta principal não é “qual tecnologia usamos?”, mas “qual condição do sistema precisamos sustentar — e como vamos provar isso?”.
Intenções técnicas para sistemas distribuídos: por que começar pelo comportamento esperado
Um erro comum em discussões de arquitetura é pular direto do requisito para a ferramenta.
Produto diz:
“O pagamento não pode ser processado duas vezes.”
E a conversa já vira:
“Então precisamos de fila?”
“Será que resolve com Kubernetes?”
“Coloca um lock distribuído?”
“E se usarmos um banco diferente?”
Talvez alguma dessas opções faça sentido. Talvez nenhuma faça. O problema é que a conversa começou no lugar errado.
Antes de decidir o mecanismo, precisamos entender o que exatamente precisa ser verdadeiro no sistema. Existe uma diferença importante entre:
- resultado de negócio: evitar cobrança duplicada para o cliente;
- intenção técnica: garantir processamento idempotente dentro de um escopo definido;
- políticas e restrições: definir prazos, limites, falhas esperadas e degradação aceitável;
- estado desejado: representar a condição que o ambiente deve sustentar;
- validação: observar se o comportamento esperado continua acontecendo.
Ferramentas entram depois disso. Uma fila pode ajudar em processamento assíncrono, mas não define sozinha o que fazer com mensagens duplicadas. Kubernetes pode recriar um pod, mas não sabe se uma cobrança foi feita duas vezes. Um cache pode reduzir latência, mas também pode expor dados antigos se o problema real for consistência.
A ordem importa porque ferramenta sem intenção clara tende a criar complexidade difícil de justificar. Às vezes o sistema precisa de uma plataforma mais robusta. Em outras, precisa de uma regra de domínio melhor modelada, um índice único, um log mais claro ou uma rotina de reconciliação.
Pagamentos: idempotência, retries e reconciliação
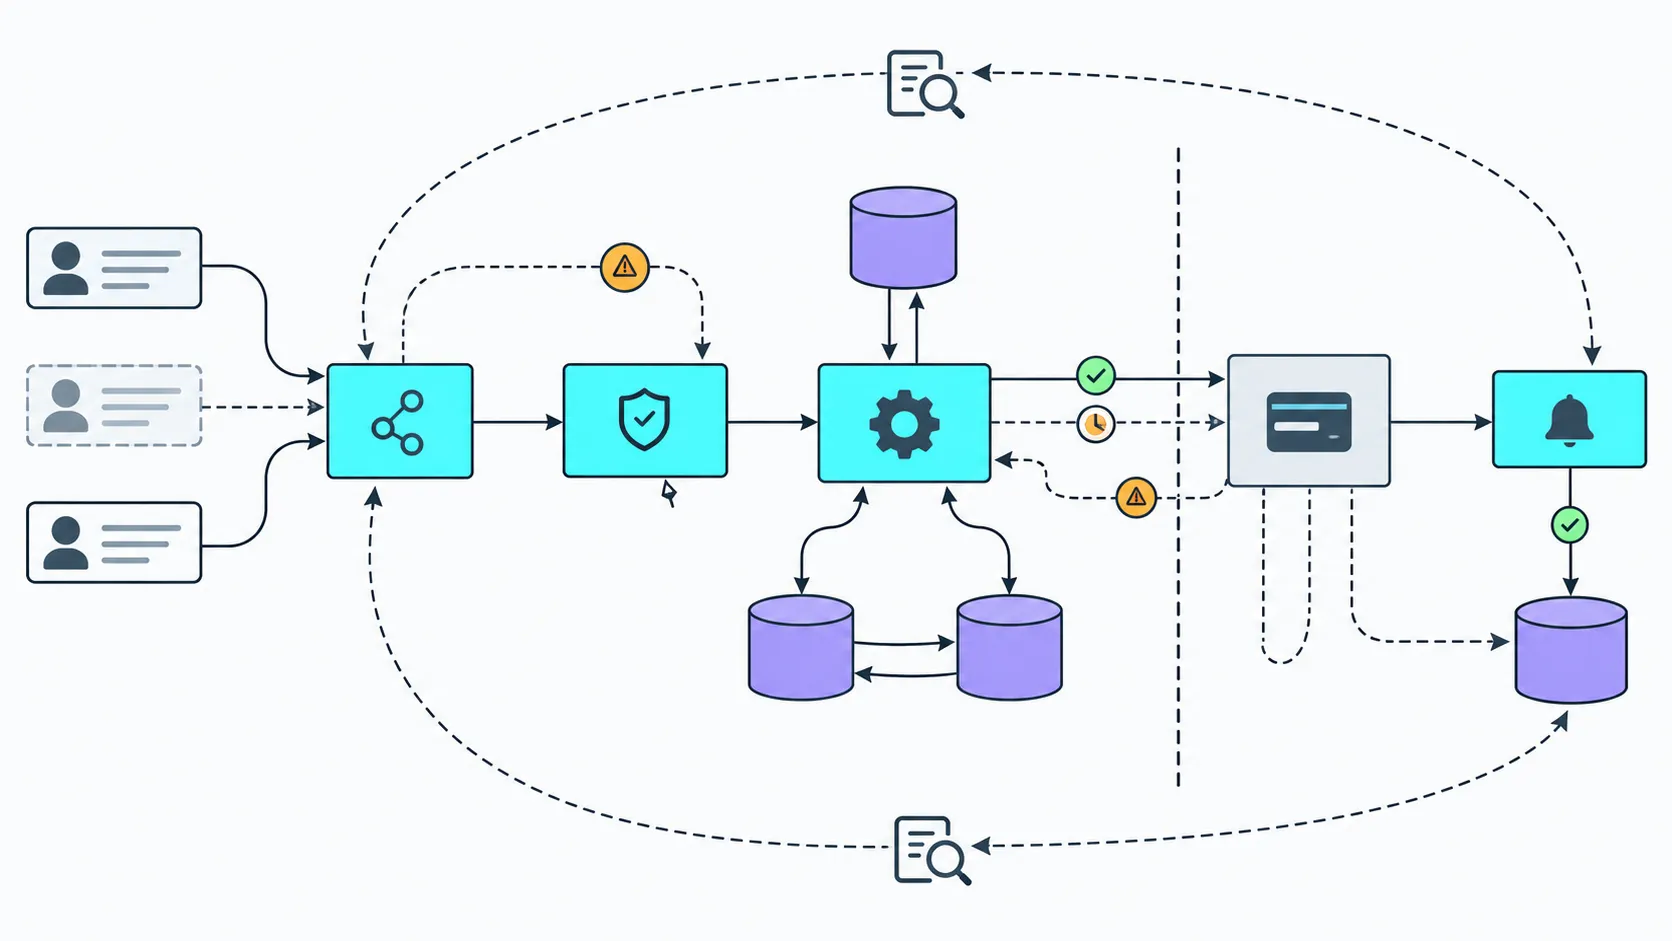
Vamos usar um exemplo fictício de pagamento. Ele não representa uma empresa real, mas ajuda a tornar visíveis problemas comuns em sistemas distribuídos: idempotência, falhas parciais, reentregas, timeouts, retries, estados intermediários e reconciliação.
Um requisito inicial poderia ser:
“O pagamento não pode ser processado duas vezes.”
Isso é compreensível do ponto de vista do produto, mas ainda é amplo demais para orientar uma decisão técnica. Podemos traduzir assim:
| Camada | Exemplo |
|---|---|
| Requisito de negócio | O cliente não deve ser cobrado duas vezes pelo mesmo pedido. |
| Intenção técnica | Uma mesma solicitação de pagamento deve produzir, no máximo, uma cobrança confirmada. |
| Restrição técnica | Reenvios, timeouts e falhas de comunicação não podem gerar uma nova cobrança para a mesma operação. |
| Estado desejado | Operações equivalentes são reconhecidas e tratadas de forma consistente. |
| Possíveis mecanismos | Chave de idempotência, registro de tentativas, índice único, controle de estado da transação, reconciliação com o provedor de pagamento. |
| Validação | Monitorar tentativas repetidas, conflitos, pedidos sem cobrança, cobranças sem pedido correspondente e divergências entre sistemas. |
Repare que ainda não escolhemos uma stack. Não falamos “tem que ser Kafka”, “tem que ser Kubernetes” ou “tem que ser banco X”. Primeiro definimos o comportamento que queremos proteger.
Também vale tomar cuidado com a expressão “exatamente uma vez”. Em sistemas distribuídos, especialmente quando há integrações externas, essa promessa pode ser difícil, cara ou inadequada dependendo das fronteiras do sistema.
Na prática, muitas soluções combinam:
- idempotência: repetir a mesma operação não deve causar um efeito duplicado;
- deduplicação: reconhecer mensagens ou requisições repetidas;
- estados intermediários explícitos: pagamento iniciado, pendente, confirmado, expirado ou falho;
- reconciliação: comparar estados entre sistemas e corrigir divergências.
O trade-off é que mais proteção contra duplicidade normalmente exige mais armazenamento, regras de expiração, tratamento de casos incompletos e decisões sobre o que fazer quando uma solicitação ficou “no meio do caminho”. Nada disso vem de graça.
Disponibilidade, desempenho, segurança e confiabilidade
Alguns requisitos aparecem com frequência em produtos digitais: disponibilidade, tempo de resposta, segurança e processamento confiável. O cuidado é não reduzir arquitetura a frases soltas como “tem que ser rápido” ou “precisa ter alta disponibilidade”.
Essas frases precisam virar comportamento observável.
Disponibilidade
Requisito de produto:
“A API deve continuar disponível em caso de falha de uma instância.”
Uma intenção técnica mais útil seria:
“O serviço não deve depender de uma única instância para atender rotas críticas.”
O estado desejado poderia ser:
“Mesmo após a perda de uma unidade de execução, ainda existe capacidade mínima para atender as operações principais.”
A validação pode envolver taxa de erros, latência, capacidade restante, falhas simuladas e impacto percebido pelos usuários. O material de confiabilidade do Google Cloud Architecture Framework é uma boa referência para pensar sobre sistemas que continuam operando diante de falhas.
Mas existe uma armadilha: declarar réplicas não prova, sozinho, que a API está disponível para os clientes. Talvez todas dependam do mesmo banco indisponível. Talvez estejam na mesma zona. Talvez o balanceador não esteja roteando corretamente. Talvez o health check diga “ok” para uma aplicação que não consegue concluir uma operação real.
Configuração ajuda, mas não é garantia por si só.
Tempo de resposta
Requisito de produto:
“A confirmação de um pedido deve ser rápida para o usuário.”
“Rápida” é uma palavra perigosa. Rápida para quem? Em qual operação? Sob qual carga? Em qual percentil?
Uma intenção técnica mais útil seria:
“A operação de confirmação do pedido deve responder dentro de um limite aceitável para a maior parte dos usuários, considerando o volume esperado de requisições.”
Aqui entram decisões como:
- qual operação estamos medindo;
- qual percentil importa;
- em quais cenários de carga;
- qual limite torna a experiência aceitável;
- o que pode ser feito de forma assíncrona depois.
Nem toda operação precisa ser otimizada no mesmo nível. Talvez a tela do usuário precise de uma confirmação rápida, mas envio de e-mail, baixa em estoque ou emissão de relatório possam acontecer depois. O ponto é separar o que afeta a experiência imediata do que pode ser processado com segurança em outro momento.
Segurança
Requisito de produto:
“Apenas usuários autorizados podem acessar documentos financeiros.”
Uma intenção técnica poderia ser:
“Cada acesso a documentos financeiros deve ser autenticado, autorizado e rastreável conforme as regras do domínio.”
Isso muda a conversa. Em vez de começar com “vamos usar ferramenta X”, o time precisa responder:
- quem pode acessar quais documentos;
- em quais condições;
- como permissões são concedidas e revogadas;
- quais acessos precisam ser auditáveis;
- como identificar tentativa indevida;
- quais dados exigem proteção adicional.
A escolha de uma ferramenta de autenticação ou autorização pode ser parte da solução, mas não substitui a política. “Usar produto X” não define, por si só, quem pode acessar o quê.
Processamento confiável
Requisito de produto:
“O usuário deve receber confirmação do pedido mesmo quando uma dependência estiver temporariamente indisponível.”
Aqui aparecem falhas parciais, reentregas, timeouts, retries, indisponibilidade temporária de dependências e consistência eventual.
Uma intenção técnica poderia ser:
“O sistema deve registrar a intenção de compra de forma durável, informar o usuário sobre o estado do pedido e concluir ou reconciliar etapas dependentes quando os serviços externos voltarem.”
Isso não significa obrigatoriamente “coloque uma fila”. Pode significar fila, banco, job periódico, outbox, workflow, processamento assíncrono ou uma solução mais simples, dependendo do contexto. Este artigo sobre processamento assíncrono com Node.js e Google Cloud Platform conversa bem com decisões envolvendo dependências lentas ou temporariamente indisponíveis.
O trade-off principal é direto: exigir confirmação síncrona em toda etapa pode simplificar a leitura do fluxo, mas tende a aumentar latência e reduzir tolerância a falhas. Por outro lado, adiar etapas exige mais cuidado com estados intermediários, comunicação com o usuário, reconciliação e suporte operacional.
Do estado desejado à validação
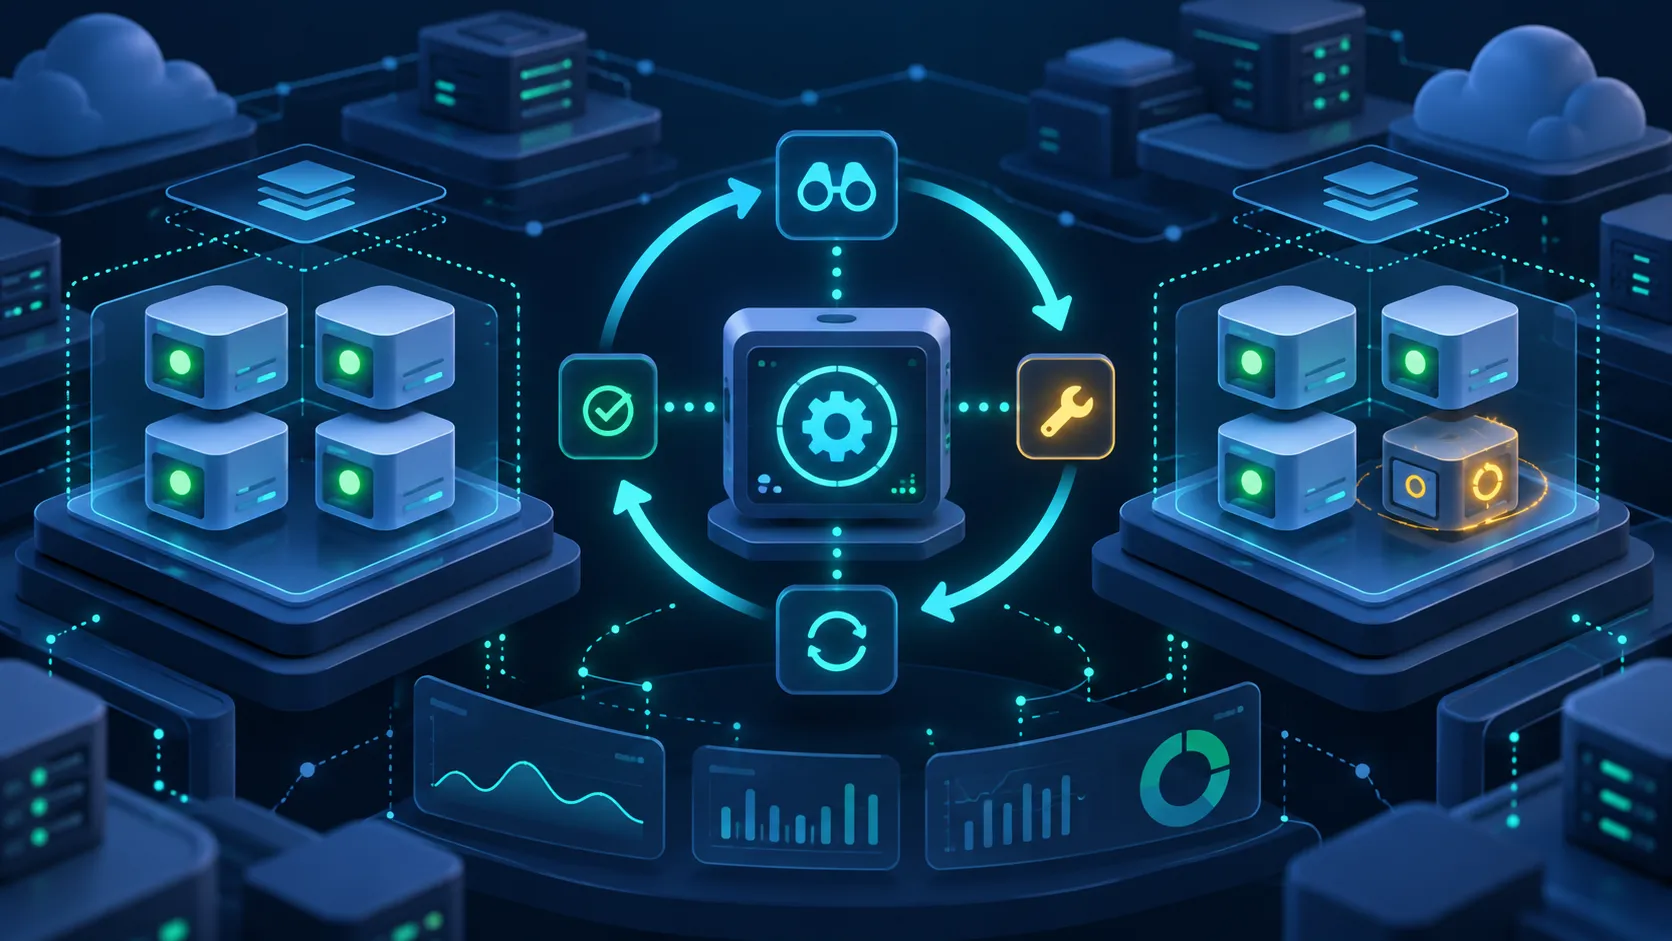
Para tornar esse raciocínio mais concreto, vale separar alguns termos.
Intenção é o resultado técnico pretendido.
Exemplo: “o serviço continua atendendo após a falha de uma instância”.
Política é o conjunto de regras, limites e condições que restringem como esse resultado pode ser alcançado.
Exemplo: “manter capacidade mínima, evitar concentração em um único ponto de falha e não aceitar tráfego em instâncias não saudáveis”.
Estado desejado é uma representação declarada da condição que o ambiente deve manter.
Exemplo: “existem réplicas suficientes, distribuídas e prontas para receber tráfego”.
Estado atual é a condição observada no sistema em determinado momento.
Exemplo: “duas réplicas estão prontas, uma está reiniciando e a taxa de erro aumentou”.
Reconciliação é o processo de comparar o estado atual com o estado desejado e agir diante de diferenças.
Exemplo: “criar uma nova réplica, retirar uma instância do balanceamento ou disparar um alerta”.
Esse modelo é especialmente útil em sistemas distribuídos porque falhas, reinicializações, mudanças de rede e indisponibilidades parciais não são exceções. Elas fazem parte do ambiente.
A armadilha é confundir configuração com garantia.
Declarar réplicas, filas, políticas de retry ou limites de CPU pode ser parte do estado desejado. Mas isso não prova que:
- o banco suporta a carga;
- o balanceador está funcionando;
- a aplicação está saudável;
- as dependências externas estão disponíveis;
- o usuário consegue concluir a jornada;
- a regra de negócio está protegida.
Por isso, a pergunta precisa ir além de “declaramos o recurso?”. Também precisamos perguntar: “o comportamento que motivou essa configuração está sendo entregue?”.
Infraestrutura declarativa, Kubernetes e Intent-Based Networking
Esse modelo mental aparece em várias tecnologias, mas com responsabilidades diferentes. É importante não colocar tudo no mesmo pacote.
Terraform e Docker Compose
Ferramentas declarativas ajudam a descrever recursos e propriedades esperadas. Em vez de pensar apenas em comandos manuais, passamos a declarar algo como:
“Este é o conjunto de recursos e configurações que deve existir.”
No Terraform, a configuração descreve recursos desejados, o que ajuda a versionar, revisar e reproduzir partes da infraestrutura. Mas um apply bem-sucedido não significa automaticamente que uma meta de confiabilidade, segurança ou desempenho foi cumprida.
Docker Compose também permite expressar serviços, portas, variáveis de ambiente, volumes, redes e dependências. Isso é útil para desenvolvimento local, testes e ambientes simples. Porém, descrever serviços locais não substitui políticas operacionais, monitoramento, tolerância a falhas ou estratégias de recuperação em produção.
Em resumo: Terraform e Docker Compose ajudam a declarar o ambiente esperado. Eles não provam, sozinhos, que a intenção técnica foi atendida.
Kubernetes e control loops
Kubernetes deixa o ciclo de reconciliação mais explícito por meio de controladores.
Conceitualmente, um controlador observa o estado atual do cluster e trabalha para aproximá-lo do estado desejado. A documentação do Kubernetes explica esse padrão na página sobre arquitetura de controladores.
Um exemplo comum é o Deployment. Ao declarar um Deployment, você expressa uma condição desejada, como uma quantidade de réplicas de uma aplicação que deve estar em execução. A documentação de Deployments no Kubernetes apresenta esse recurso como uma forma de gerenciar aplicações e atualizações declarativamente.
Ainda assim, Kubernetes não substitui entendimento de domínio. Ele pode recriar um pod que caiu, mas não sabe se uma cobrança foi duplicada, se uma autorização foi aplicada corretamente ou se a experiência do usuário continua aceitável.
Controladores reduzem trabalho manual de recuperação, mas o time ainda precisa definir limites, probes, critérios de sucesso, dependências críticas, alertas, políticas de atualização e estratégias de rollback.
Intent-Based Networking
Intent-Based Networking, ou IBN, leva uma ideia parecida para redes: em vez de depender apenas de configurações isoladas em dispositivos, a proposta é expressar o resultado esperado da rede e verificar se ele continua sendo atendido.
A RFC 9315 apresenta uma visão sobre Intent-Based Networking como abordagem para trabalhar com intenções, políticas e validação no contexto de redes.
Trazendo para o modelo deste artigo:
| Camada | Exemplo em rede |
|---|---|
| Intenção | Determinadas aplicações podem se comunicar entre si com propriedades esperadas. |
| Política | Segmentação, regras de segurança, conectividade permitida e restrições de desempenho. |
| Estado desejado | Comportamento esperado da rede para aqueles fluxos. |
| Validação | Checagem contínua de aderência e detecção de desvios. |
O ponto não é dizer que todo time precisa adotar uma plataforma de IBN. Também não é vender rede “autônoma” como resposta universal. A ponte importante é o modelo mental:
declarar o resultado desejado, observar o estado real e agir quando houver desvio.
Automação sem intenção clara só faz a coisa errada acontecer mais rápido.
Um roteiro prático para o próximo requisito
Na próxima vez que aparecer um requisito como “tem que ser rápido”, “não pode duplicar” ou “precisa continuar disponível”, tente seguir este roteiro antes de escolher a tecnologia.
-
Escreva a necessidade de negócio em linguagem do produto.
Exemplo: “o cliente precisa receber confirmação do pedido mesmo se uma dependência estiver temporariamente indisponível”. -
Defina o comportamento técnico observável que protege essa necessidade.
Exemplo: “o sistema registra o pedido de forma durável, informa um estado compreensível ao usuário e processa etapas pendentes quando a dependência voltar”. -
Escolha métricas, limites e condições de falha relevantes.
Exemplo: tempo máximo para responder ao usuário, taxa de pedidos pendentes, pedidos sem confirmação, falhas de integração e tempo de reconciliação. -
Registre políticas e restrições antes de selecionar ferramentas.
Exemplo: quais etapas precisam ser síncronas, quais podem ser assíncronas, quais dados exigem consistência mais forte e quais estados precisam ser auditáveis. -
Declare o estado desejado onde fizer sentido.
Exemplo: serviços necessários, workers, filas, tarefas agendadas, réplicas, políticas de retry, limites operacionais e sinais de saúde. -
Defina como comparar resultado esperado, estado atual e experiência real do usuário.
Exemplo: dashboards, alertas, logs estruturados, trilhas de auditoria, testes de falha e reconciliação entre pedido, pagamento e confirmação.
Aplicando ao requisito:
“O usuário deve receber confirmação do pedido mesmo quando uma dependência estiver temporariamente indisponível.”
Uma tradução mais útil poderia ser:
| Camada | Exemplo |
|---|---|
| Requisito de negócio | O usuário não deve ficar sem resposta ao finalizar um pedido por causa de uma dependência temporariamente indisponível. |
| Intenção técnica | O sistema registra a intenção do pedido de forma durável e informa um estado confiável ao usuário. |
| Política | A confirmação visual pode ser imediata, mas etapas externas podem ficar pendentes e ser reconciliadas depois. |
| Estado desejado | Pedidos pendentes são armazenados, processados posteriormente e não se perdem em reinicializações. |
| Possíveis mecanismos | Banco transacional, fila, job de reconciliação, processamento assíncrono, retentativas controladas. |
| Validação | Monitorar pedidos pendentes, tempo de conclusão, falhas de integração e divergências entre sistemas. |
Só depois disso faz sentido discutir se a solução envolve fila, banco, réplicas, Kubernetes, serviço gerenciado ou algo mais simples. A tecnologia entra para sustentar uma intenção, não para substituir o pensamento.
Próximos Passos
Se quiser aplicar esse modelo no seu time, uma prática simples é pegar um requisito real da próxima planning e escrever quatro frases antes de discutir ferramenta:
- O negócio precisa que...
- Tecnicamente, isso significa que o sistema deve...
- Esse comportamento vale quando...
- Vamos saber que falhou se observarmos...
Depois disso, a conversa sobre infraestrutura, arquitetura e operação tende a ficar menos abstrata.
Boas decisões de arquitetura começam menos pela pergunta “qual tecnologia usamos?” e mais por:
Qual condição do sistema precisamos sustentar — e como vamos provar isso?