Frases como “el pago no puede procesarse dos veces”, “la API debe seguir disponible” o “la confirmación del pedido debe ser rápida” son requisitos importantes. Pero, por sí solas, todavía no indican qué arquitectura usar, qué infraestructura declarar o qué comportamiento observar en producción.
Antes de elegir una cola, Kubernetes, una caché, una base de datos o cualquier otra herramienta, debemos entender el contexto. ¿Esta aplicación atiende a pocas personas o a miles? ¿Es algo nuevo o ya tiene cuellos de botella? ¿Depende de un servicio externo? ¿Durante cuánto tiempo puede estar indisponible? Al final, el contexto importa.
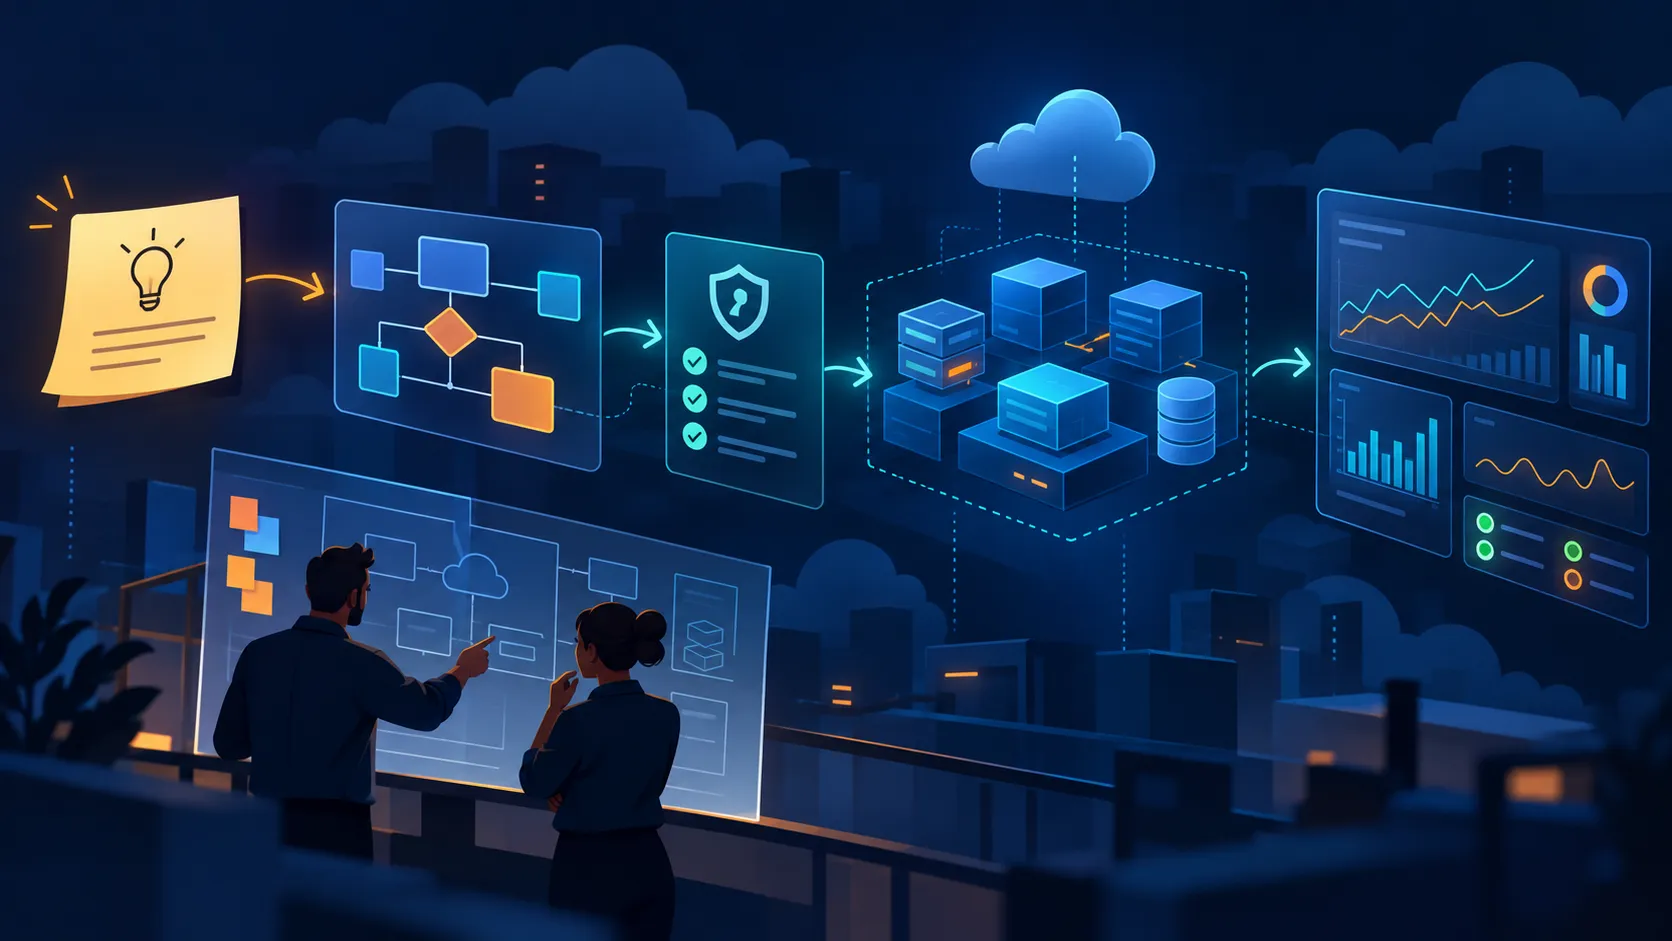
El objetivo de este artículo es defender un modelo mental: transformar los requisitos de negocio en intenciones técnicas para sistemas distribuidos. Es decir, describir qué condición debe sostener el sistema, bajo qué restricciones, cómo se manifiesta en el entorno y cómo sabremos cuando haya dejado de ser cierta.
La mejor solución no es necesariamente la más compleja. Es la que resuelve el problema de forma sencilla, mantiene el sistema confiable y no se convierte en otra cosa difícil de mantener, corregir y explicar después.
TL;DR
- Un requisito de negocio no es lo mismo que una decisión técnica.
- “No cobrar dos veces” puede convertirse en una intención técnica como: “una misma solicitud de pago debe producir, como máximo, un cobro confirmado”.
- La política define límites y condiciones: alcance, plazos, autorización, tolerancia a fallos y degradación aceptable.
- El estado deseado es una forma declarada de representar una condición que el entorno debe mantener.
- La observabilidad, las pruebas y la reconciliación cierran el ciclo: sin validación, la intención no pasa de ser una frase bonita.
- Terraform y Docker Compose ayudan a declarar entornos esperados; Kubernetes e Intent-Based Networking hacen más explícito el ciclo de observar el estado actual y actuar ante las desviaciones.
- La pregunta principal no es “¿qué tecnología usamos?”, sino “¿qué condición del sistema necesitamos sostener y cómo vamos a demostrarlo?”.
Intenciones técnicas para sistemas distribuidos: por qué empezar por el comportamiento esperado
Un error común en las discusiones de arquitectura es saltar directamente del requisito a la herramienta.
Producto dice:
“El pago no puede procesarse dos veces”.
Y la conversación ya se convierte en:
“Entonces, ¿necesitamos una cola?”
“¿Será suficiente con Kubernetes?”
“¿Ponemos un lock distribuido?”
“¿Y si usamos otra base de datos?”
Quizás alguna de estas opciones tenga sentido. Quizás ninguna lo tenga. El problema es que la conversación comenzó en el lugar equivocado.
Antes de decidir el mecanismo, debemos entender qué debe ser verdadero exactamente en el sistema. Existe una diferencia importante entre:
- resultado de negocio: evitar el cobro duplicado al cliente;
- intención técnica: garantizar un procesamiento idempotente dentro de un alcance definido;
- políticas y restricciones: definir plazos, límites, fallos esperados y degradación aceptable;
- estado deseado: representar la condición que el entorno debe sostener;
- validación: observar si el comportamiento esperado continúa ocurriendo.
Las herramientas entran después de esto. Una cola puede ayudar en el procesamiento asíncrono, pero por sí sola no define qué hacer con los mensajes duplicados. Kubernetes puede recrear un pod, pero no sabe si un cobro se realizó dos veces. Una caché puede reducir la latencia, pero también puede exponer datos antiguos si el problema real es la consistencia.
El orden importa porque una herramienta sin una intención clara tiende a crear una complejidad difícil de justificar. A veces el sistema necesita una plataforma más robusta. Otras veces necesita una regla de dominio mejor modelada, un índice único, un log más claro o una rutina de reconciliación.
Pagos: idempotencia, retries y reconciliación
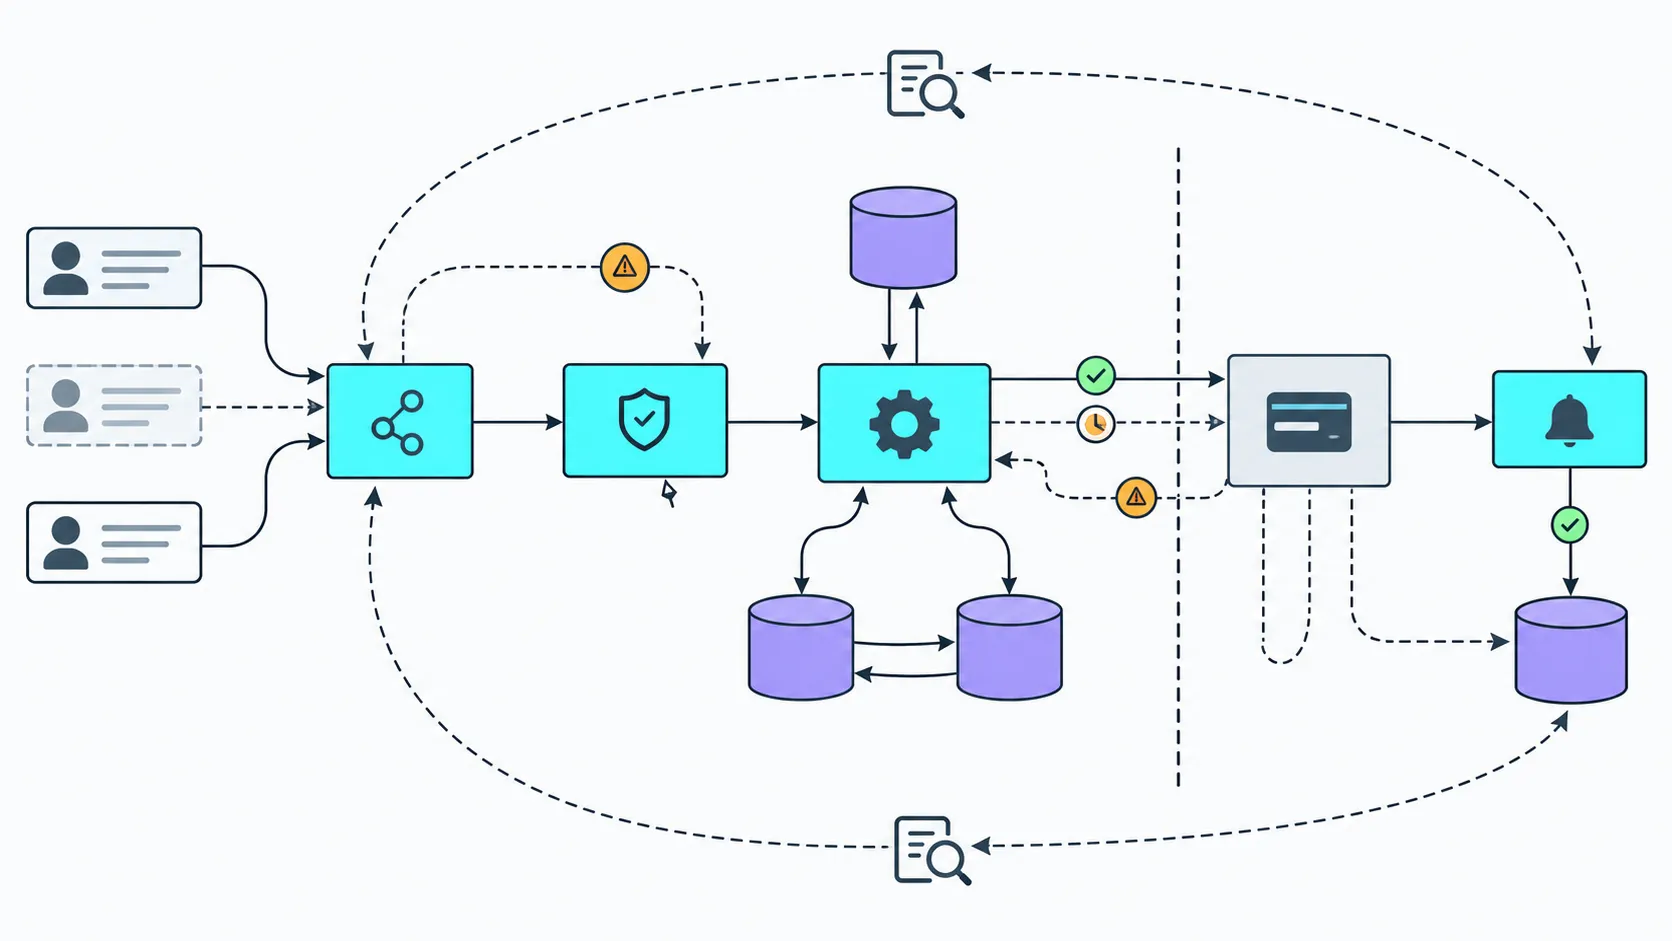
Usaremos un ejemplo ficticio de pago. No representa a una empresa real, pero ayuda a hacer visibles problemas comunes en sistemas distribuidos: idempotencia, fallos parciales, reentregas, timeouts, retries, estados intermedios y reconciliación.
Un requisito inicial podría ser:
“El pago no puede procesarse dos veces”.
Esto es comprensible desde el punto de vista del producto, pero todavía es demasiado amplio para orientar una decisión técnica. Podemos traducirlo así:
| Capa | Ejemplo |
|---|---|
| Requisito de negocio | El cliente no debe recibir dos cobros por el mismo pedido. |
| Intención técnica | Una misma solicitud de pago debe producir, como máximo, un cobro confirmado. |
| Restricción técnica | Los reenvíos, timeouts y fallos de comunicación no pueden generar un nuevo cobro para la misma operación. |
| Estado deseado | Las operaciones equivalentes se reconocen y se tratan de forma consistente. |
| Mecanismos posibles | Clave de idempotencia, registro de intentos, índice único, control del estado de la transacción, reconciliación con el proveedor de pagos. |
| Validación | Monitorizar intentos repetidos, conflictos, pedidos sin cobro, cobros sin un pedido correspondiente y divergencias entre sistemas. |
Observa que todavía no hemos elegido un stack. No hemos dicho “tiene que ser Kafka”, “tiene que ser Kubernetes” o “tiene que ser la base de datos X”. Primero definimos el comportamiento que queremos proteger.
También conviene tener cuidado con la expresión “exactamente una vez”. En sistemas distribuidos, especialmente cuando existen integraciones externas, esta promesa puede ser difícil, costosa o inadecuada, según las fronteras del sistema.
En la práctica, muchas soluciones combinan:
- idempotencia: repetir la misma operación no debe causar un efecto duplicado;
- deduplicación: reconocer mensajes o solicitudes repetidas;
- estados intermedios explícitos: pago iniciado, pendiente, confirmado, expirado o fallido;
- reconciliación: comparar estados entre sistemas y corregir divergencias.
El trade-off es que una mayor protección contra duplicidades normalmente exige más almacenamiento, reglas de expiración, tratamiento de casos incompletos y decisiones sobre qué hacer cuando una solicitud quedó “a medio camino”. Nada de esto es gratuito.
Disponibilidad, rendimiento, seguridad y confiabilidad
Algunos requisitos aparecen con frecuencia en los productos digitales: disponibilidad, tiempo de respuesta, seguridad y procesamiento confiable. El cuidado consiste en no reducir la arquitectura a frases sueltas como “tiene que ser rápido” o “necesita alta disponibilidad”.
Estas frases deben convertirse en comportamientos observables.
Disponibilidad
Requisito de producto:
“La API debe seguir disponible en caso de fallo de una instancia”.
Una intención técnica más útil sería:
“El servicio no debe depender de una única instancia para atender las rutas críticas”.
El estado deseado podría ser:
“Incluso después de perder una unidad de ejecución, todavía existe capacidad mínima para atender las operaciones principales”.
La validación puede incluir la tasa de errores, la latencia, la capacidad restante, fallos simulados y el impacto percibido por los usuarios. El material de confiabilidad del Google Cloud Architecture Framework es una buena referencia para pensar en sistemas que continúan funcionando ante los fallos.
Pero existe una trampa: declarar réplicas no demuestra, por sí solo, que la API esté disponible para los clientes. Quizás todas dependan de la misma base de datos indisponible. Quizás estén en la misma zona. Quizás el balanceador no esté enrutando correctamente. Quizás el health check indique “ok” para una aplicación que no puede completar una operación real.
La configuración ayuda, pero no es una garantía por sí sola.
Tiempo de respuesta
Requisito de producto:
“La confirmación de un pedido debe ser rápida para el usuario”.
“Rápida” es una palabra peligrosa. ¿Rápida para quién? ¿En qué operación? ¿Con qué carga? ¿En qué percentil?
Una intención técnica más útil sería:
“La operación de confirmación del pedido debe responder dentro de un límite aceptable para la mayoría de los usuarios, considerando el volumen esperado de solicitudes”.
Aquí entran decisiones como:
- qué operación estamos midiendo;
- qué percentil importa;
- en qué escenarios de carga;
- qué límite hace que la experiencia sea aceptable;
- qué puede hacerse de forma asíncrona después.
No todas las operaciones necesitan optimizarse al mismo nivel. Quizás la pantalla del usuario necesite una confirmación rápida, pero el envío del correo electrónico, la actualización del inventario o la generación de un informe puedan ocurrir después. El punto es separar lo que afecta a la experiencia inmediata de lo que puede procesarse de forma segura en otro momento.
Seguridad
Requisito de producto:
“Solo los usuarios autorizados pueden acceder a documentos financieros”.
Una intención técnica podría ser:
“Cada acceso a documentos financieros debe estar autenticado, autorizado y ser trazable de acuerdo con las reglas del dominio”.
Esto cambia la conversación. En lugar de comenzar con “vamos a usar la herramienta X”, el equipo debe responder:
- quién puede acceder a qué documentos;
- en qué condiciones;
- cómo se conceden y revocan los permisos;
- qué accesos deben ser auditables;
- cómo identificar un intento indebido;
- qué datos requieren protección adicional.
La elección de una herramienta de autenticación o autorización puede formar parte de la solución, pero no sustituye a la política. “Usar el producto X” no define, por sí solo, quién puede acceder a qué.
Procesamiento confiable
Requisito de producto:
“El usuario debe recibir la confirmación del pedido incluso cuando una dependencia esté temporalmente indisponible”.
Aquí aparecen los fallos parciales, las reentregas, los timeouts, los retries, la indisponibilidad temporal de dependencias y la consistencia eventual.
Una intención técnica podría ser:
“El sistema debe registrar de forma duradera la intención de compra, informar al usuario sobre el estado del pedido y completar o reconciliar las etapas dependientes cuando los servicios externos vuelvan a estar disponibles”.
Esto no significa necesariamente “pon una cola”. Puede significar una cola, una base de datos, un job periódico, un outbox, un workflow, un procesamiento asíncrono o una solución más sencilla, según el contexto. Este artículo sobre procesamiento asíncrono con Node.js y Google Cloud Platform dialoga bien con decisiones que involucran dependencias lentas o temporalmente indisponibles.
El trade-off principal es directo: exigir una confirmación síncrona en cada etapa puede simplificar la lectura del flujo, pero tiende a aumentar la latencia y reducir la tolerancia a fallos. Por otro lado, posponer etapas exige más cuidado con los estados intermedios, la comunicación con el usuario, la reconciliación y la operación del soporte.
Del estado deseado a la validación
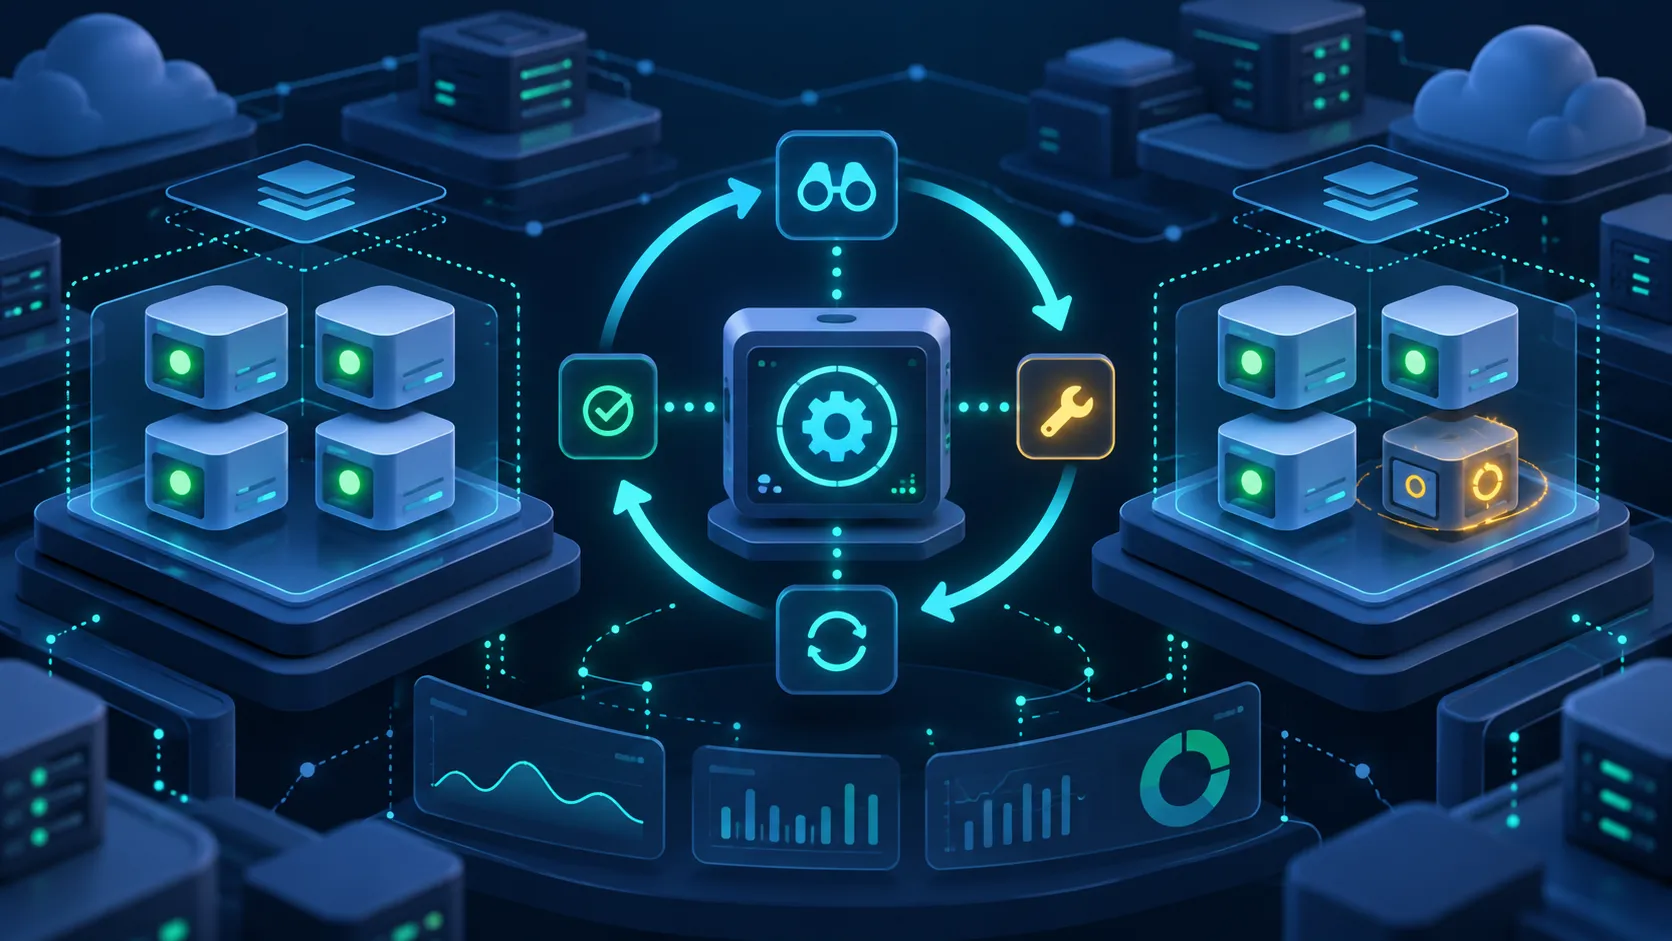
Para hacer este razonamiento más concreto, conviene separar algunos términos.
Intención es el resultado técnico pretendido.
Ejemplo: “el servicio continúa atendiendo después del fallo de una instancia”.
Política es el conjunto de reglas, límites y condiciones que restringen cómo puede alcanzarse ese resultado.
Ejemplo: “mantener una capacidad mínima, evitar la concentración en un único punto de fallo y no aceptar tráfico en instancias que no estén saludables”.
Estado deseado es una representación declarada de la condición que el entorno debe mantener.
Ejemplo: “existen suficientes réplicas, distribuidas y listas para recibir tráfico”.
Estado actual es la condición observada en el sistema en un momento determinado.
Ejemplo: “dos réplicas están listas, una se está reiniciando y la tasa de errores aumentó”.
Reconciliación es el proceso de comparar el estado actual con el estado deseado y actuar ante las diferencias.
Ejemplo: “crear una nueva réplica, retirar una instancia del balanceo o activar una alerta”.
Este modelo es especialmente útil en sistemas distribuidos porque los fallos, reinicios, cambios de red e indisponibilidades parciales no son excepciones. Forman parte del entorno.
La trampa consiste en confundir configuración con garantía.
Declarar réplicas, colas, políticas de retry o límites de CPU puede formar parte del estado deseado. Pero esto no demuestra que:
- la base de datos soporte la carga;
- el balanceador esté funcionando;
- la aplicación esté saludable;
- las dependencias externas estén disponibles;
- el usuario pueda completar el recorrido;
- la regla de negocio esté protegida.
Por eso, la pregunta debe ir más allá de “¿declaramos el recurso?”. También debemos preguntar: “¿se está entregando el comportamiento que motivó esta configuración?”.
Infraestructura declarativa, Kubernetes e Intent-Based Networking
Este modelo mental aparece en varias tecnologías, pero con responsabilidades diferentes. Es importante no ponerlas todas en el mismo paquete.
Terraform y Docker Compose
Las herramientas declarativas ayudan a describir los recursos y las propiedades esperadas. En lugar de pensar únicamente en comandos manuales, pasamos a declarar algo como:
“Este es el conjunto de recursos y configuraciones que debe existir”.
En Terraform, la configuración describe los recursos deseados, lo que ayuda a versionar, revisar y reproducir partes de la infraestructura. Pero un apply exitoso no significa automáticamente que se haya cumplido una meta de confiabilidad, seguridad o rendimiento.
Docker Compose también permite expresar servicios, puertos, variables de entorno, volúmenes, redes y dependencias. Esto es útil para el desarrollo local, las pruebas y los entornos sencillos. Sin embargo, describir servicios locales no sustituye a las políticas operativas, la monitorización, la tolerancia a fallos ni las estrategias de recuperación en producción.
En resumen: Terraform y Docker Compose ayudan a declarar el entorno esperado. Por sí solos, no demuestran que se haya cumplido la intención técnica.
Kubernetes y los control loops
Kubernetes hace más explícito el ciclo de reconciliación mediante controladores.
Conceptualmente, un controlador observa el estado actual del clúster y trabaja para acercarlo al estado deseado. La documentación de Kubernetes explica este patrón en la página sobre arquitectura de controladores.
Un ejemplo común es Deployment. Al declarar un Deployment, expresas una condición deseada, como una cantidad de réplicas de una aplicación que debe estar en ejecución. La documentación sobre Deployments en Kubernetes presenta este recurso como una forma de gestionar aplicaciones y actualizaciones de manera declarativa.
Aun así, Kubernetes no sustituye la comprensión del dominio. Puede recrear un pod que se cayó, pero no sabe si un cobro se duplicó, si una autorización se aplicó correctamente o si la experiencia del usuario continúa siendo aceptable.
Los controladores reducen el trabajo manual de recuperación, pero el equipo todavía debe definir límites, probes, criterios de éxito, dependencias críticas, alertas, políticas de actualización y estrategias de rollback.
Intent-Based Networking
Intent-Based Networking, o IBN, lleva una idea similar a las redes: en lugar de depender únicamente de configuraciones aisladas en los dispositivos, la propuesta es expresar el resultado esperado de la red y verificar si continúa cumpliéndose.
La RFC 9315 presenta una visión sobre Intent-Based Networking como enfoque para trabajar con intenciones, políticas y validación en el contexto de las redes.
Llevándolo al modelo de este artículo:
| Capa | Ejemplo en una red |
|---|---|
| Intención | Determinadas aplicaciones pueden comunicarse entre sí con las propiedades esperadas. |
| Política | Segmentación, reglas de seguridad, conectividad permitida y restricciones de rendimiento. |
| Estado deseado | Comportamiento esperado de la red para esos flujos. |
| Validación | Comprobación continua de la adherencia y detección de desviaciones. |
El objetivo no es decir que todos los equipos deban adoptar una plataforma de IBN. Tampoco se trata de vender una red “autónoma” como respuesta universal. El puente importante es el modelo mental:
declarar el resultado deseado, observar el estado real y actuar cuando haya una desviación.
La automatización sin una intención clara solo hace que la acción equivocada ocurra más rápido.
Un guion práctico para el próximo requisito
La próxima vez que aparezca un requisito como “tiene que ser rápido”, “no puede duplicarse” o “debe seguir disponible”, intenta seguir este guion antes de elegir la tecnología.
-
Escribe la necesidad de negocio en el lenguaje del producto.
Ejemplo: “el cliente debe recibir la confirmación del pedido incluso si una dependencia está temporalmente indisponible”. -
Define el comportamiento técnico observable que protege esa necesidad.
Ejemplo: “el sistema registra el pedido de forma duradera, informa al usuario de un estado comprensible y procesa las etapas pendientes cuando la dependencia vuelva”. -
Elige las métricas, los límites y las condiciones de fallo relevantes.
Ejemplo: tiempo máximo para responder al usuario, tasa de pedidos pendientes, pedidos sin confirmación, fallos de integración y tiempo de reconciliación. -
Registra las políticas y restricciones antes de seleccionar las herramientas.
Ejemplo: qué etapas deben ser síncronas, cuáles pueden ser asíncronas, qué datos requieren una consistencia más fuerte y qué estados deben ser auditables. -
Declara el estado deseado donde tenga sentido.
Ejemplo: servicios necesarios, workers, colas, tareas programadas, réplicas, políticas de retry, límites operativos y señales de salud. -
Define cómo comparar el resultado esperado, el estado actual y la experiencia real del usuario.
Ejemplo: dashboards, alertas, logs estructurados, pistas de auditoría, pruebas de fallos y reconciliación entre el pedido, el pago y la confirmación.
Aplicado al requisito:
“El usuario debe recibir la confirmación del pedido incluso cuando una dependencia esté temporalmente indisponible”.
Una traducción más útil podría ser:
| Capa | Ejemplo |
|---|---|
| Requisito de negocio | El usuario no debe quedarse sin respuesta al finalizar un pedido debido a una dependencia temporalmente indisponible. |
| Intención técnica | El sistema registra de forma duradera la intención del pedido e informa al usuario de un estado confiable. |
| Política | La confirmación visual puede ser inmediata, pero las etapas externas pueden quedar pendientes y reconciliarse después. |
| Estado deseado | Los pedidos pendientes se almacenan, se procesan posteriormente y no se pierden durante los reinicios. |
| Mecanismos posibles | Base de datos transaccional, cola, job de reconciliación, procesamiento asíncrono y reintentos controlados. |
| Validación | Monitorizar los pedidos pendientes, el tiempo de finalización, los fallos de integración y las divergencias entre sistemas. |
Solo después de esto tiene sentido discutir si la solución incluye una cola, una base de datos, réplicas, Kubernetes, un servicio gestionado o algo más sencillo. La tecnología entra para sostener una intención, no para sustituir el pensamiento.
Próximos pasos
Si quieres aplicar este modelo en tu equipo, una práctica sencilla consiste en tomar un requisito real de la próxima planning y escribir cuatro frases antes de discutir una herramienta:
- El negocio necesita que...
- Técnicamente, esto significa que el sistema debe...
- Este comportamiento se aplica cuando...
- Sabremos que ha fallado si observamos...
Después de esto, la conversación sobre infraestructura, arquitectura y operación tiende a ser menos abstracta.
Las buenas decisiones de arquitectura comienzan menos con la pregunta “¿qué tecnología usamos?” y más con esta:
¿Qué condición del sistema necesitamos sostener y cómo vamos a demostrarlo?