Una alerta se dispara a las tres de la mañana: la tasa de errores del servicio de checkout aumentó. El gráfico muestra que algo se rompió, pero no qué solicitud, qué cliente ni qué línea de código. La trazabilidad con Loki y VictoriaMetrics es la práctica de conectar esos dos extremos: partir de una métrica agregada y llegar, sin adivinanzas, a las líneas de log de las solicitudes que causaron el problema.
En esta guía, montarás ese puente con tres piezas open source: VictoriaMetrics para las métricas, Loki para los logs y Grafana Alloy como colector único. El secreto no está en ninguna herramienta aislada, sino en un contrato simple: las mismas etiquetas y el mismo identificador de solicitud en ambos lados.
Por qué las métricas y los logs por sí solos no bastan
Las métricas son baratas y rápidas. Una serie como http_requests_total{service="checkout", code="500"} responde en milisegundos cuántas solicitudes fallaron en los últimos cinco minutos. Pero es agregada por naturaleza: no sabe nada de una solicitud específica.
Los logs son lo opuesto. Cada línea cuenta la historia de un evento, con detalles, pero buscar "el error correcto" entre millones de líneas sin un punto de partida es lento y frustrante.
La trazabilidad nace cuando puedes hacer la pregunta en ambas direcciones:
- De la métrica al log: "este pico de errores 500 en checkout, entre las 03:02 y las 03:07, ¿de qué solicitudes provino?"
- Del log a la métrica: "este error de timeout en la base de datos, ¿es un caso aislado o forma parte de una tendencia?"
Para eso, las métricas y los logs deben hablar el mismo idioma.
El contrato: etiquetas comunes y un identificador por solicitud
Antes de configurar cualquier herramienta, acuerda con el equipo un contrato mínimo. Tiene dos partes.
1. Etiquetas de baja cardinalidad, iguales en ambos lados. Elige pocas etiquetas que identifiquen de dónde proviene el dato y usa exactamente los mismos nombres y valores en las métricas y los logs:
| Etiqueta | Ejemplo | Para qué sirve |
|---|---|---|
service |
checkout |
Qué aplicación |
env |
prod |
Qué entorno |
instance |
checkout-7f9c |
Qué réplica o host |
Si la métrica indica service="checkout" y el log indica app="Checkout", el puente falla. Estandariza los nombres una vez y aplícalos en el colector, no en cada aplicación.
2. Un trace_id en cada línea de log. Cada solicitud recibe un identificador único al entrar al sistema y lo propaga a los servicios siguientes. El estándar W3C Trace Context (el encabezado traceparent) ya resuelve esto, y las bibliotecas de OpenTelemetry lo propagan automáticamente. La aplicación solo necesita escribir ese identificador en los logs, preferentemente en JSON:
{"ts":"2026-11-02T03:04:11Z","level":"error","service":"checkout","trace_id":"4bf92f3577b34da6a3ce929d0e0e4736","msg":"payment gateway timeout","duration_ms":5003}
Observa la diferencia de función: service es una etiqueta (pocos valores), mientras que trace_id es un dato de la línea (un valor por solicitud). Esta distinción es la que mantiene rápido a Loki, como verás a continuación.
Trazabilidad con Loki y VictoriaMetrics en la práctica
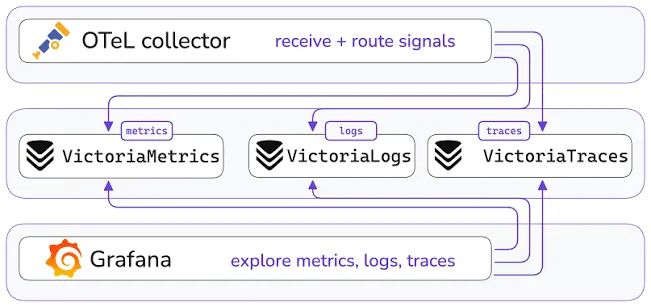
La arquitectura queda así: la aplicación expone métricas en formato Prometheus y escribe logs en JSON. Alloy recopila ambos, aplica el contrato de etiquetas y envía las métricas a VictoriaMetrics (mediante remote write) y los logs a Loki. Grafana consulta ambos.
Métricas en VictoriaMetrics
VictoriaMetrics es compatible con el ecosistema de Prometheus: acepta remote write, entiende PromQL y ofrece MetricsQL, un superconjunto con funciones adicionales. En Alloy, la recopilación y el envío quedan así:
prometheus.scrape "checkout" {
  targets = [{
    "__address__" = "checkout:8080",
    "service"     = "checkout",
    "env"         = "prod",
  }]
  forward_to = [prometheus.remote_write.victoria.receiver]
}

prometheus.remote_write "victoria" {
  endpoint {
    url = "http://victoriametrics:8428/api/v1/write"
  }
}
Con esto, la tasa de errores por servicio se obtiene mediante una consulta directa:
sum by (service) (rate(http_requests_total{env="prod", code=~"5.."}[5m]))
Logs en Loki, con trace_id en el lugar correcto
Loki indexa únicamente las etiquetas de cada flujo de logs; el contenido de la línea no se indexa. Por eso, colocar trace_id como etiqueta sería un error clásico: cada solicitud crearía un flujo nuevo, la cardinalidad se dispararía y Loki se volvería lento y costoso.
El lugar correcto es el structured metadata, disponible en Loki 3: un campo adjunto a la línea, filtrable en las consultas, pero fuera del índice de flujos. En Alloy:
loki.process "checkout" {
  stage.json {
    expressions = { trace_id = "trace_id", level = "level" }
  }
  stage.labels {
    values = { level = "" }
  }
  stage.structured_metadata {
    values = { trace_id = "" }
  }
  stage.static_labels {
    values = { service = "checkout", env = "prod" }
  }
  forward_to = [loki.write.default.receiver]
}

loki.write "default" {
  endpoint {
    url = "http://loki:3100/loki/api/v1/push"
  }
}
Observa que service y env tienen los mismos nombres y valores que se usan en las métricas. Aquí es donde el contrato se convierte en configuración.
Del pico en el gráfico a la línea de log
Con todo en su lugar, la investigación de la alerta de las tres de la mañana se convierte en un recorrido corto:
- En el panel de métricas, la consulta de errores muestra el pico en
service="checkout"entre las 03:02 y las 03:07. - En Explore de Grafana, con la fuente Loki y el mismo intervalo de tiempo, filtra usando las mismas etiquetas:
logql
   {service="checkout", env="prod", level="error"} | json
- Una línea llama la atención:
payment gateway timeout. Incluye eltrace_id. Ahora puedes filtrar por él, sin necesidad de indexarlo:
logql
   {env="prod"} | trace_id="4bf92f3577b34da6a3ce929d0e0e4736"
La consulta devuelve todas las líneas de esa solicitud, en todos los servicios que atravesó y en orden. Esa es la trazabilidad real: la historia completa de una solicitud.
- De vuelta en las métricas, confirma si el problema es sistémico. ¿La latencia del gateway aumentó para todos o solo para esta solicitud?
promql
   histogram_quantile(0.99, sum by (le) (rate(gateway_request_duration_seconds_bucket{service="checkout"}[5m])))
Para acortar aún más el camino, configura en Grafana un enlace de datos en los paneles de métricas que abra Explore de Loki con las mismas etiquetas y el mismo intervalo. Y, si también guardas traces en un backend dedicado, usa los derived fields de la fuente Loki para transformar el trace_id de cada línea en un enlace en el que se pueda hacer clic hacia el trace.
Alertas que ya apuntan a los logs
El último paso es hacer que la alerta incluya el puente. Con vmalert (el evaluador de reglas de VictoriaMetrics), las anotaciones de la regla pueden incluir la consulta de logs ya preparada:
groups:
  - name: checkout
    rules:
      - alert: CheckoutErrorRateHigh
        expr: sum(rate(http_requests_total{service="checkout", env="prod", code=~"5.."}[5m])) > 1
        for: 5m
        labels:
          severity: page
        annotations:
          summary: "Erros 5xx elevados no checkout"
          logs: '{service="checkout", env="prod", level="error"} | json'
Quien recibe la alerta ya sabe por dónde empezar, sin tener que montar la consulta a toda prisa.
Errores comunes
- Etiquetas divergentes.
servicede un lado,appdel otro. Estandarízalas en el colector y revísalas cuando se incorpore un servicio nuevo. trace_idcomo etiqueta en Loki. Hace que la cardinalidad se dispare. Usa structured metadata o deja el campo en el JSON y extráelo con| json.- Logs sin
trace_iden parte del recorrido. Basta con que un servicio no propaguetraceparentpara que la historia quede incompleta. Trata la propagación como un requisito, no como un detalle. - Relojes desincronizados. Si los hosts no sincronizan la hora (NTP), la ventana de tiempo del gráfico no coincidirá con la de los logs.
- Etiquetas de alta cardinalidad en las métricas. Incluir el identificador de usuario o de pedido en una métrica es el mismo error que usar
trace_idcomo etiqueta en Loki, solo que en VictoriaMetrics. Esos datos pertenecen a los logs.
Próximos pasos
Empieza de a poco: elige un servicio crítico, aplica el contrato de etiquetas, garantiza el trace_id en los logs y monta el recorrido "del gráfico a la línea de log" para una alerta real. Cuando funcione de extremo a extremo, replica el patrón en los demás servicios. La herramienta más importante de esta trazabilidad no es Loki ni VictoriaMetrics: es el contrato que hace que ambos se comuniquen.