Um alerta dispara às três da manhã: a taxa de erros do serviço de checkout subiu. O gráfico mostra que algo quebrou, mas não qual requisição, qual cliente nem qual linha de código. Rastreabilidade com Loki e VictoriaMetrics é a prática de ligar essas duas pontas: partir de uma métrica agregada e chegar, sem adivinhação, às linhas de log das requisições que causaram o problema.
Neste guia, você vai montar essa ponte com três peças open source: VictoriaMetrics para as métricas, Loki para os logs e Grafana Alloy como coletor único. O segredo não está em nenhuma ferramenta isolada, e sim em um contrato simples: as mesmas etiquetas e o mesmo identificador de requisição nos dois lados.
Por que métricas e logs sozinhos não bastam
Métricas são baratas e rápidas. Uma série como http_requests_total{service="checkout", code="500"} responde em milissegundos quantas requisições falharam nos últimos cinco minutos. Mas ela é agregada por natureza: não sabe nada de uma requisição específica.
Logs são o oposto. Cada linha conta a história de um evento, com detalhes, mas procurar "o erro certo" em milhões de linhas sem um ponto de partida é lento e frustrante.
A rastreabilidade nasce quando você consegue fazer a pergunta nas duas direções:
- Da métrica para o log: "este pico de erros 500 no checkout, entre 03:02 e 03:07, veio de quais requisições?"
- Do log para a métrica: "este erro de timeout no banco é um caso isolado ou faz parte de uma tendência?"
Para isso, métricas e logs precisam falar a mesma língua.
O contrato: etiquetas comuns e um identificador por requisição
Antes de configurar qualquer ferramenta, combine com o time um contrato mínimo. Ele tem duas partes.
1. Etiquetas de baixa cardinalidade, iguais nos dois lados. Escolha poucas etiquetas que identificam de onde veio o dado, e use exatamente os mesmos nomes e valores em métricas e logs:
| Etiqueta | Exemplo | Para que serve |
|---|---|---|
service |
checkout |
Qual aplicação |
env |
prod |
Qual ambiente |
instance |
checkout-7f9c |
Qual réplica ou host |
Se a métrica diz service="checkout" e o log diz app="Checkout", a ponte cai. Padronize os nomes uma vez e aplique no coletor, não em cada aplicação.
2. Um trace_id em toda linha de log. Cada requisição recebe um identificador único na entrada do sistema e o propaga para os serviços seguintes. O padrão W3C Trace Context (o cabeçalho traceparent) já resolve isso, e as bibliotecas do OpenTelemetry o propagam automaticamente. A aplicação só precisa escrever esse identificador nos logs, de preferência em JSON:
{"ts":"2026-11-02T03:04:11Z","level":"error","service":"checkout","trace_id":"4bf92f3577b34da6a3ce929d0e0e4736","msg":"payment gateway timeout","duration_ms":5003}
Note a diferença de papel: service é etiqueta (poucos valores), trace_id é dado da linha (um valor por requisição). Essa distinção é o que mantém o Loki rápido, como você vai ver a seguir.
Rastreabilidade com Loki e VictoriaMetrics na prática
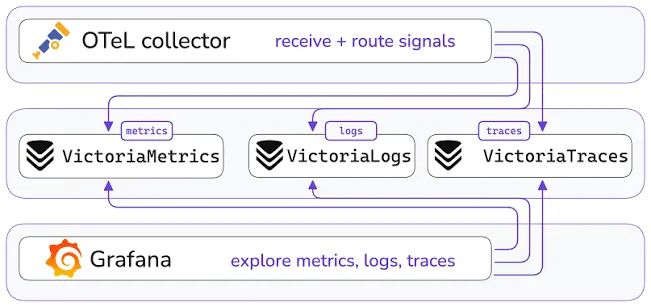
A arquitetura fica assim: a aplicação expõe métricas no formato Prometheus e escreve logs em JSON. O Alloy coleta os dois, aplica o contrato de etiquetas e envia métricas para o VictoriaMetrics (via remote write) e logs para o Loki. O Grafana consulta os dois.
Métricas no VictoriaMetrics
O VictoriaMetrics é compatível com o ecossistema Prometheus: aceita remote write, entende PromQL e oferece o MetricsQL, um superconjunto com funções extras. No Alloy, a coleta e o envio ficam assim:
prometheus.scrape "checkout" {
  targets = [{
    "__address__" = "checkout:8080",
    "service"     = "checkout",
    "env"         = "prod",
  }]
  forward_to = [prometheus.remote_write.victoria.receiver]
}

prometheus.remote_write "victoria" {
  endpoint {
    url = "http://victoriametrics:8428/api/v1/write"
  }
}
Com isso, a taxa de erros por serviço é uma consulta direta:
sum by (service) (rate(http_requests_total{env="prod", code=~"5.."}[5m]))
Logs no Loki, com o trace_id no lugar certo
O Loki indexa apenas as etiquetas de cada fluxo de log; o conteúdo da linha não é indexado. Por isso, colocar o trace_id como etiqueta seria um erro clássico: cada requisição criaria um fluxo novo, a cardinalidade explodiria e o Loki ficaria lento e caro.
O lugar certo é o structured metadata, disponível no Loki 3: um campo anexado à linha, filtrável nas consultas, mas fora do índice de fluxos. No Alloy:
loki.process "checkout" {
  stage.json {
    expressions = { trace_id = "trace_id", level = "level" }
  }
  stage.labels {
    values = { level = "" }
  }
  stage.structured_metadata {
    values = { trace_id = "" }
  }
  stage.static_labels {
    values = { service = "checkout", env = "prod" }
  }
  forward_to = [loki.write.default.receiver]
}

loki.write "default" {
  endpoint {
    url = "http://loki:3100/loki/api/v1/push"
  }
}
Repare que service e env têm os mesmos nomes e valores usados nas métricas. É aqui que o contrato vira configuração.
Do pico no gráfico à linha de log
Com tudo no lugar, a investigação do alerta das três da manhã vira um roteiro curto:
- No painel de métricas, a consulta de erros mostra o pico em
service="checkout"entre 03:02 e 03:07. - No Explore do Grafana, com a fonte Loki e o mesmo intervalo de tempo, você filtra pelas mesmas etiquetas:
logql
   {service="checkout", env="prod", level="error"} | json
- Uma linha chama a atenção:
payment gateway timeout. Ela traz otrace_id. Agora você filtra por ele, sem precisar indexá-lo:
logql
   {env="prod"} | trace_id="4bf92f3577b34da6a3ce929d0e0e4736"
A consulta devolve todas as linhas daquela requisição, em todos os serviços que ela atravessou, em ordem. Essa é a rastreabilidade de fato: a história completa de uma requisição.
- De volta às métricas, você confirma se o problema é sistêmico. A latência do gateway subiu para todo mundo ou só para essa requisição?
promql
   histogram_quantile(0.99, sum by (le) (rate(gateway_request_duration_seconds_bucket{service="checkout"}[5m])))
Para encurtar ainda mais o caminho, configure no Grafana um link de dados nos painéis de métricas que abra o Explore do Loki com as mesmas etiquetas e o mesmo intervalo. E, se você também guarda traces em um backend dedicado, use os derived fields da fonte Loki para transformar o trace_id de cada linha em um link clicável para o trace.
Alertas que já apontam para os logs
O último passo é fazer o alerta carregar a ponte consigo. Com o vmalert (o avaliador de regras do VictoriaMetrics), as anotações da regra podem incluir a consulta de logs já pronta:
groups:
  - name: checkout
    rules:
      - alert: CheckoutErrorRateHigh
        expr: sum(rate(http_requests_total{service="checkout", env="prod", code=~"5.."}[5m])) > 1
        for: 5m
        labels:
          severity: page
        annotations:
          summary: "Erros 5xx elevados no checkout"
          logs: '{service="checkout", env="prod", level="error"} | json'
Quem recebe o alerta já sabe por onde começar, sem montar a consulta na pressa.
Armadilhas comuns
- Etiquetas divergentes.
servicede um lado,appdo outro. Padronize no coletor e revise quando um serviço novo entrar. trace_idcomo etiqueta no Loki. Explode a cardinalidade. Use structured metadata ou deixe o campo no JSON e extraia com| json.- Logs sem
trace_idem parte do caminho. Basta um serviço que não propaga otraceparentpara a história ficar pela metade. Trate a propagação como requisito, não como detalhe. - Relógios desalinhados. Se os hosts não sincronizam o horário (NTP), a janela de tempo do gráfico não bate com a dos logs.
- Etiquetas de alta cardinalidade nas métricas. Identificador de usuário ou de pedido em métrica é o mesmo erro do
trace_idno Loki, só que no VictoriaMetrics. Esses dados pertencem aos logs.
Próximos passos
Comece pequeno: escolha um serviço crítico, aplique o contrato de etiquetas, garanta o trace_id nos logs e monte o roteiro "do gráfico à linha de log" para um alerta real. Quando ele funcionar de ponta a ponta, replique o padrão para os outros serviços. A ferramenta mais importante dessa rastreabilidade não é o Loki nem o VictoriaMetrics: é o contrato que faz os dois conversarem.